Apsara Conference 2026(雲栖大会、2026年9月、杭州)の展示から、世界モデルとPhysical AIに関わるものを拾っていくと、話題の中心がモデルそのものより「つなぎ方」にあることに気づきます。操作に応じて映像を作り続けるモデル、言葉の指示をロボットアームの軌道に変えるモデル、ロボットの学習データを作る開発基盤、そしてそれらを結ぶ通信網。会場ではこれらが別々のブースで、別々の説明をされていました。
この記事では、撮影した展示パネルと映像を順に見ながら、それぞれが何を訴えていたのかを日本語で読み解きます。そのうえで、公式文書で確かめられた範囲を補い、筆者の見方と条件付きの予測を述べ、日本企業の仕事にどう関わるかを考えます。なお、ここで扱う展示は用途ごとに独立したものです。一つの完成したシステムとして展示されていたわけではありません。
「神経系」と書かれたパネル
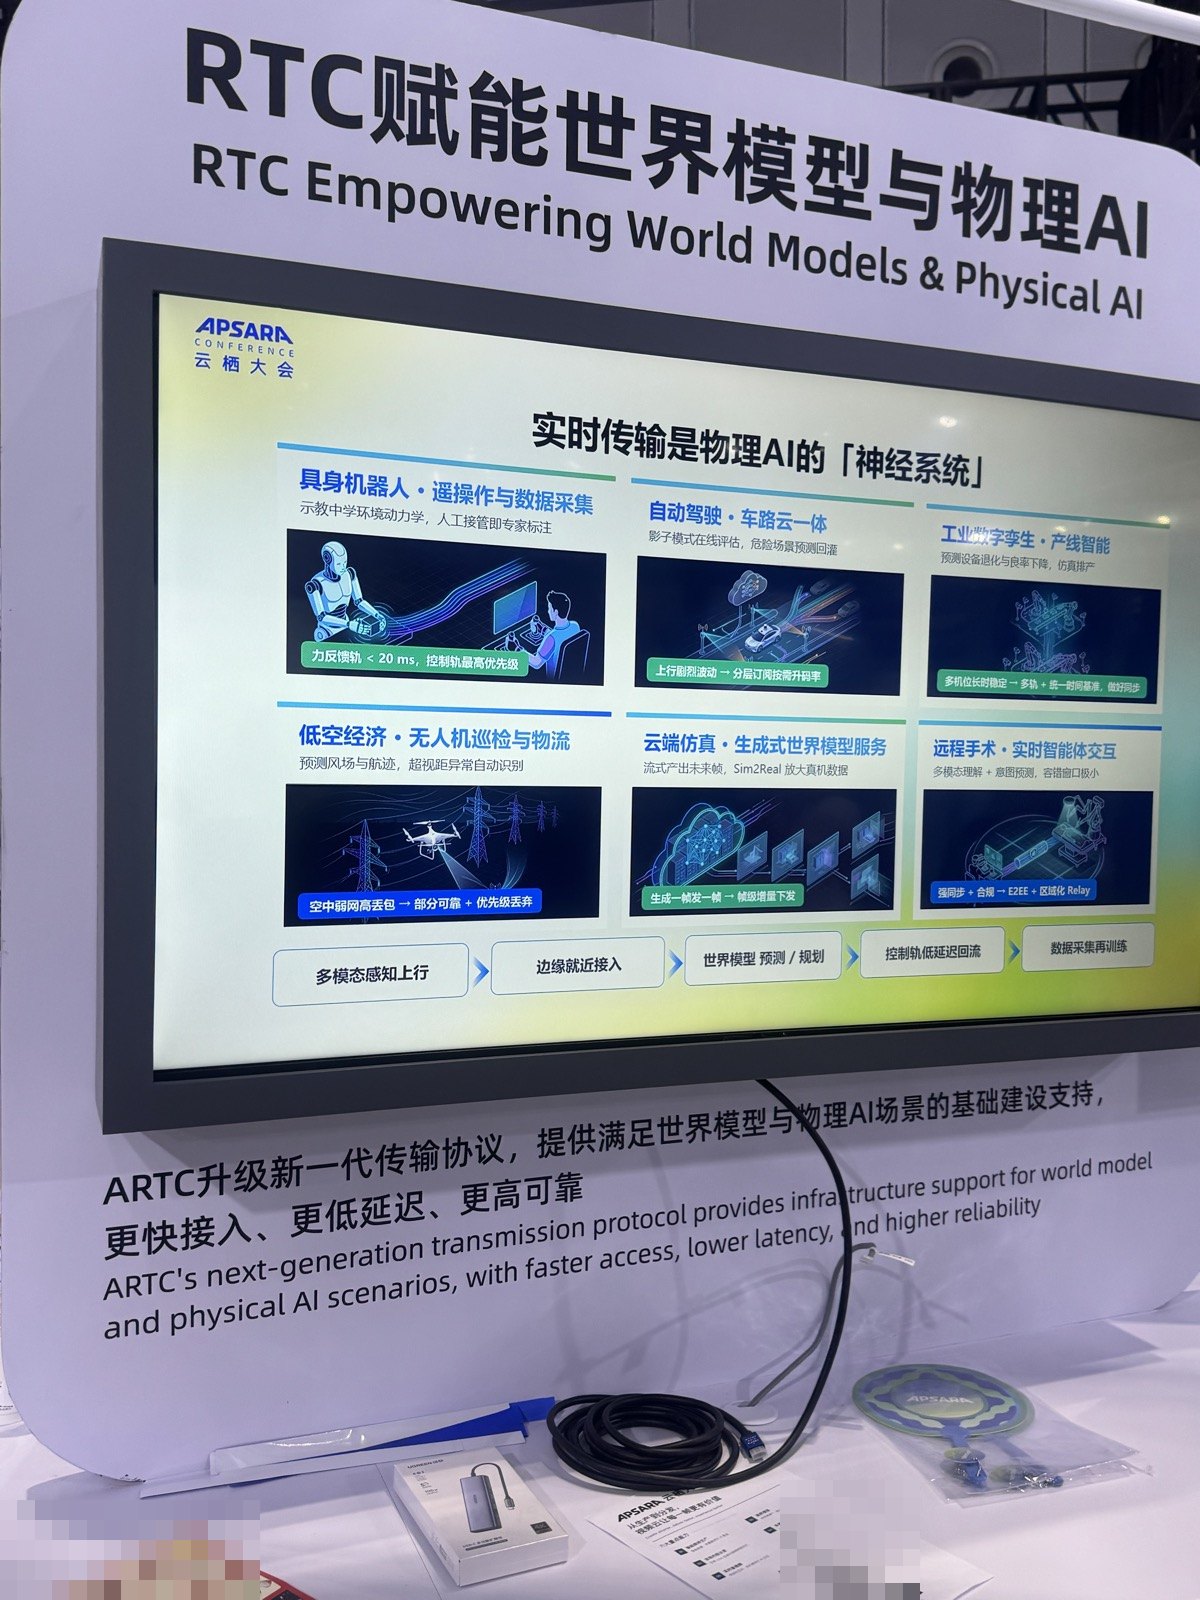
最初に取り上げるのは、アリババクラウドのリアルタイム通信(RTC)を紹介するパネルです。上部の見出しは「RTC赋能世界模型与物理AI」、英語で「RTC Empowering World Models & Physical AI」。直訳すれば「RTCが世界モデルとPhysical AIに力を与える」ですが、言いたいことは画面の中央に書かれた一文のほうがはっきりしています。「实时传输是物理AI的『神经系统』」、つまり「リアルタイム伝送はPhysical AIの神経系である」。
画面には用途が六つ並んでいました。左上から順に、ロボットの遠隔操作とデータ収集、自動運転と車・道路・クラウドの連携、工場のデジタルツイン、ドローンによる巡回点検と物流(中国で「低空経済」と呼ばれる分野)、クラウド上のシミュレーションと生成型の世界モデルサービス、そして遠隔手術です。それぞれのイラストの下に、通信上の工夫が一行ずつ添えられています。
読み取れた範囲で訳すと、遠隔操作の欄には「力覚フィードバックの経路は20ミリ秒未満、制御の経路を最優先」とあります。自動運転の欄は「上り方向の変動が激しい場合は階層化して、必要に応じて品質を上げる」。デジタルツインは「複数の機器の位置を長時間安定させるため、複数経路と共通の時刻基準で同期する」。ドローンは「上空の弱い電波で損失が多い場合は、一部だけ確実に届け、優先度で捨てる」。シミュレーションの欄は「一枚生成したら一枚送る、差分だけを送る」。遠隔手術は「強い同期、合流、端から端までの暗号化、地域単位の中継」です。
画面の下端には五つの箱が矢印でつながっていました。「多モーダルの感知を上り方向へ」「最寄りのエッジから接続」「世界モデルによる予測・計画」「制御を低遅延で戻す」「データを集めて再学習」。センサーの情報を送り、近くで受け、先を予測し、命令を返し、結果を学習に回す。一周するとループになる図です。パネル下部の説明文には「ARTCは次世代の伝送プロトコルに更新し、世界モデルとPhysical AIの場面に必要な基盤を提供する。より速い接続、より低い遅延、より高い信頼性」と書かれていました。
このパネルは、Physical AIの話を「賢いモデル」ではなく「届く時間」から始めていました。六つの用途のうち、通信の注記がすべて違います。力覚は遅延、自動運転は上り帯域の揺れ、デジタルツインは時刻の揃え方、ドローンは損失、世界モデルはフレームの送り方、手術は同期と暗号化。ひとくちに「低遅延」と言っても、用途ごとに困りごとの種類が違うことを、一枚で見せていました。
公式文書で確かめられた内容も書いておきます。アリババクラウドの中国向け製品ページでは、RTCは「全世界をカバーするリアルタイム音声・映像の開発基盤」で、DingTalk(钉钉)の会議と同じ基盤を使い、端から端までの遅延は「最短150ミリ秒」と説明されています。同じページには、リアルタイムメッセージ機能の遅延が「最短25ミリ秒」で、AIとのやり取りのメッセージ伝送にも使えるという記載もありました。一方、パネルにある「ARTC」という名称の製品ページや仕様書は、今回取得できませんでした。展示の「20ミリ秒未満」は展示側の目標値の表示であり、公式仕様として確認できた数字ではありません。150ミリ秒は音声・映像通話の端から端までの値、20ミリ秒は力覚という別の種類の信号の値で、比べる対象も測り方も違います。二つを並べて「どれだけ速くなったか」を論じることはできません。
動画を作るAIと、世界を作るAI
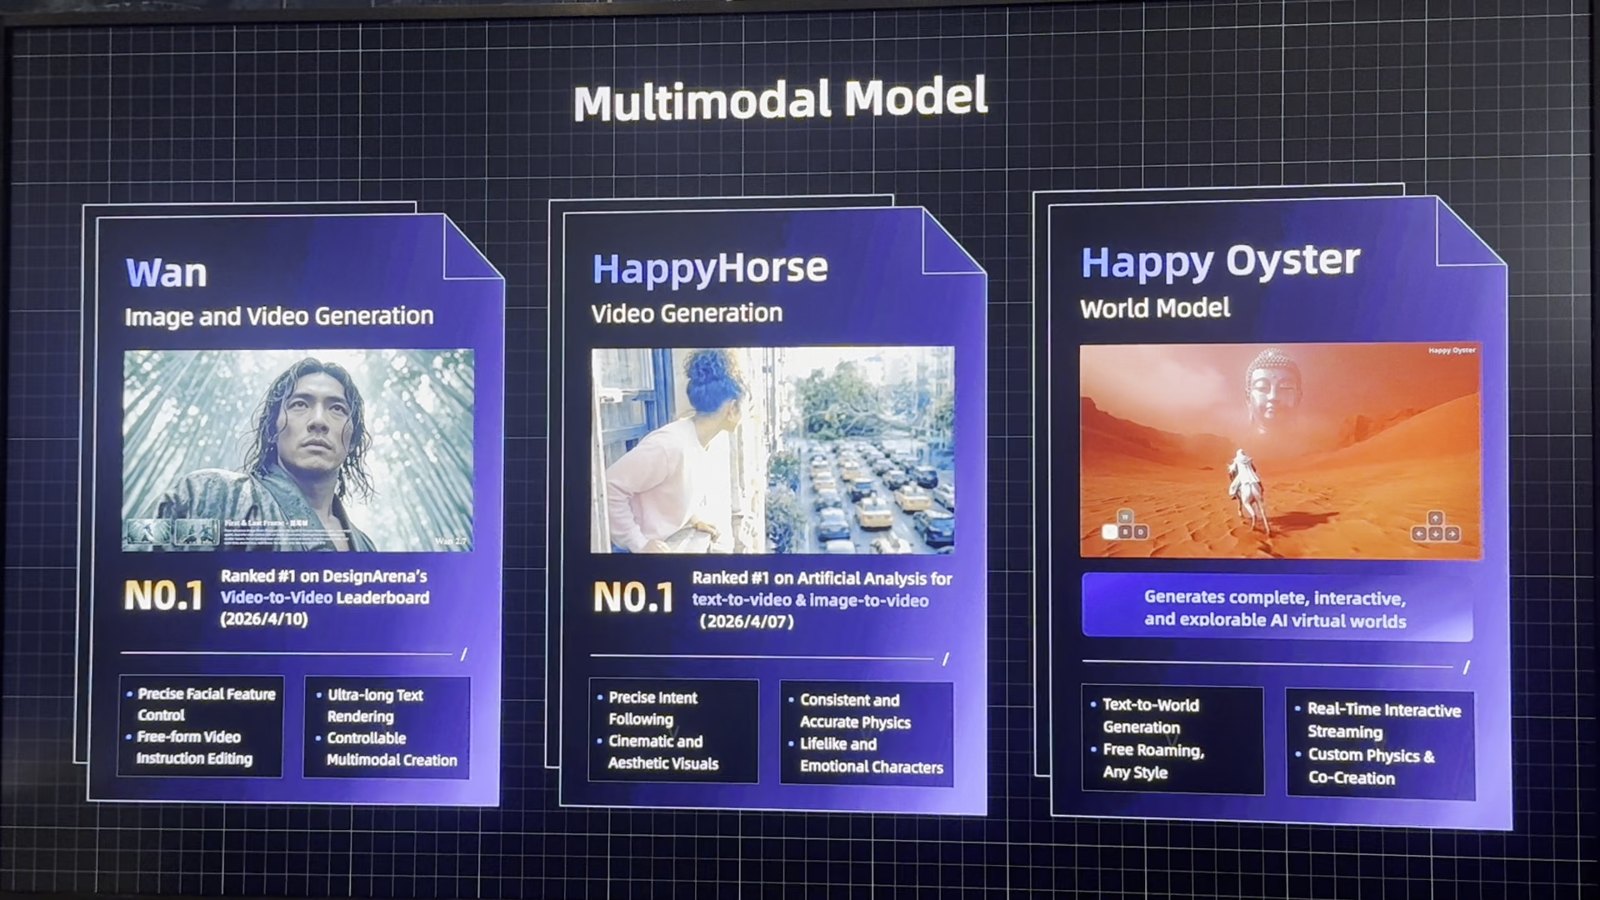
パネルの六つの用途のうち、五つめの「生成型の世界モデルサービス」に対応する展示が、別の区画にありました。「Multimodal Model」と題した大型画面で、三枚のカードが並んでいます。左から「Wan:Image and Video Generation(画像・動画生成)」、「HappyHorse:Video Generation(動画生成)」、そして「Happy Oyster:World Model(世界モデル)」。撮影した約55秒の動画では、カード内の作例映像が数秒ごとに切り替わっていました。
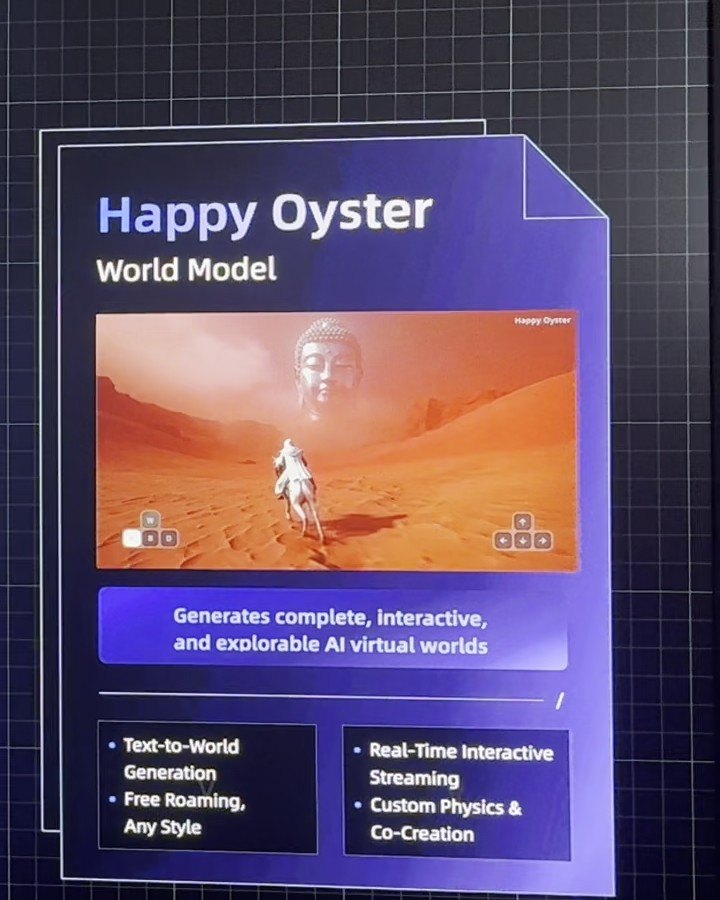
Happy Oysterのカードには「Generates complete, interactive, and explorable AI virtual worlds(完結した、操作できる、探索可能なAI仮想世界を生成する)」とあり、その下に四つの特徴が書かれていました。「Text-to-World Generation(文章から世界を生成)」「Free Roaming, Any Style(自由に歩き回れる、画風を問わない)」「Real-Time Interactive Streaming(リアルタイムの対話的な配信)」「Custom Physics & Co-Creation(物理法則の設定と共同制作)」。作例の画面は、砂漠を白い馬に乗った人物が進んでいく場面で、左下にW・A・S・Dに相当するキー、右下に矢印キーのアイコンが表示されていました。ゲームの操作画面を思わせる見せ方です。
カードの見出しの違いが、この記事の題にある「生成と操作の違い」をそのまま示しています。WanとHappyHorseは、指示を受けて画像や動画を一本作るモデルとして紹介されていました。Happy Oysterは、利用者の操作を受けながら次の場面を作り続けるモデルとして紹介されています。前者の成果物は完成したファイルで、後者の成果物は時間とともに続く状態です。
Happy Oysterの公式サイト(happyoyster.cn)では、製品を「リアルタイムに操作できるオープンワールドの世界モデル製品で、リアルタイムの世界の創造と操作に対応する」と説明しています。文字・音声・画像で「世界を演出(Directing)」するか、一人称で「世界を歩き回る(Wandering)」ことができ、音声と映像はリアルタイムに生成され、光や動き、場面の因果関係が一貫するように作られているとも書かれていました。ただし、サイト上で運営会社を特定できる記載は取得したページには見当たらず、アリババクラウドとの関係は展示で並んでいたという事実以上には確認できていません。
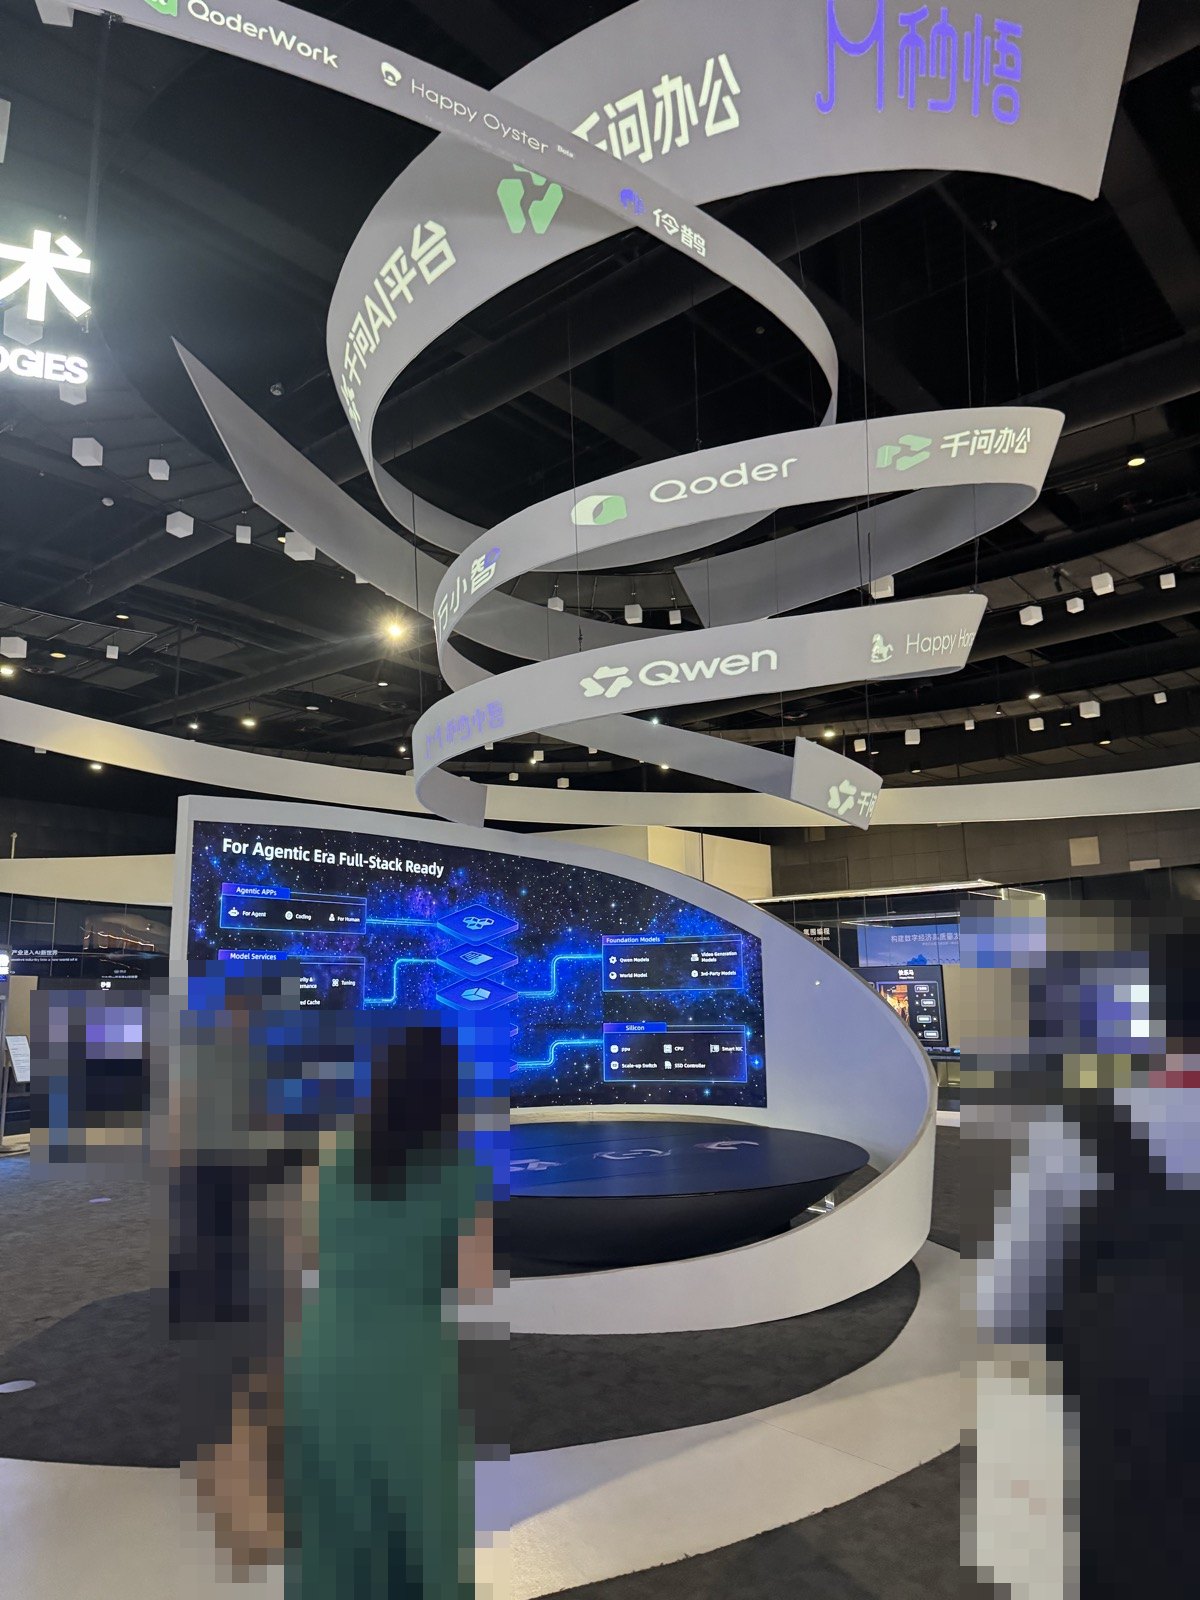
あわせて訪問したAlibaba Cloud本社では、Qwen、Qoder、千問オフィス(千问办公)などの名前とともに、Happy Oysterの名前が螺旋状の吊り看板に掲げられていました。会場全体の構成パネル(特集ページで紹介)でも、基盤モデルの列に「World Model:HappyOyster」と書かれています。展示の上では、世界モデルは言語モデルや動画生成モデルと同じ棚に置かれた製品の一つという扱いでした。
世界モデルという言葉は、研究の文脈では「現在の状態と行動を入力すると、次の状態を予測するモデル」を指すことが多い言葉です。動画生成モデルとの違いは、行動という入力が時間の途中で何度も入ってくる点にあります。一本の動画を作るなら、最初に指示を受けて最後まで作れば済みます。世界モデルでは、利用者がキーを押すたびに次の数フレームを作り直す必要があります。ここで先ほどのRTCパネルの注記が効いてきます。シミュレーションの欄にあった「一枚生成したら一枚送る、差分だけを送る」は、この連続生成をネットワーク越しに届ける方法の説明として読めます。操作してから画面が変わるまでの時間は、生成の速さと、伝送の速さの合計で決まるからです。
筆者の見方を書いておくと、Happy Oysterのような製品は、まず娯楽と制作の道具として使われるはずです。作例の見せ方もゲームに近いものでした。一方で、同じ仕組みは、ロボットや自動運転の学習用に「起こりうる場面」を大量に作る用途にもつながります。この二つ目の使い道は、後で取り上げる開発基盤の展示で、別の製品名とともに実際に示されていました。
ロボットの前に並んだ、かごとお椀と野菜
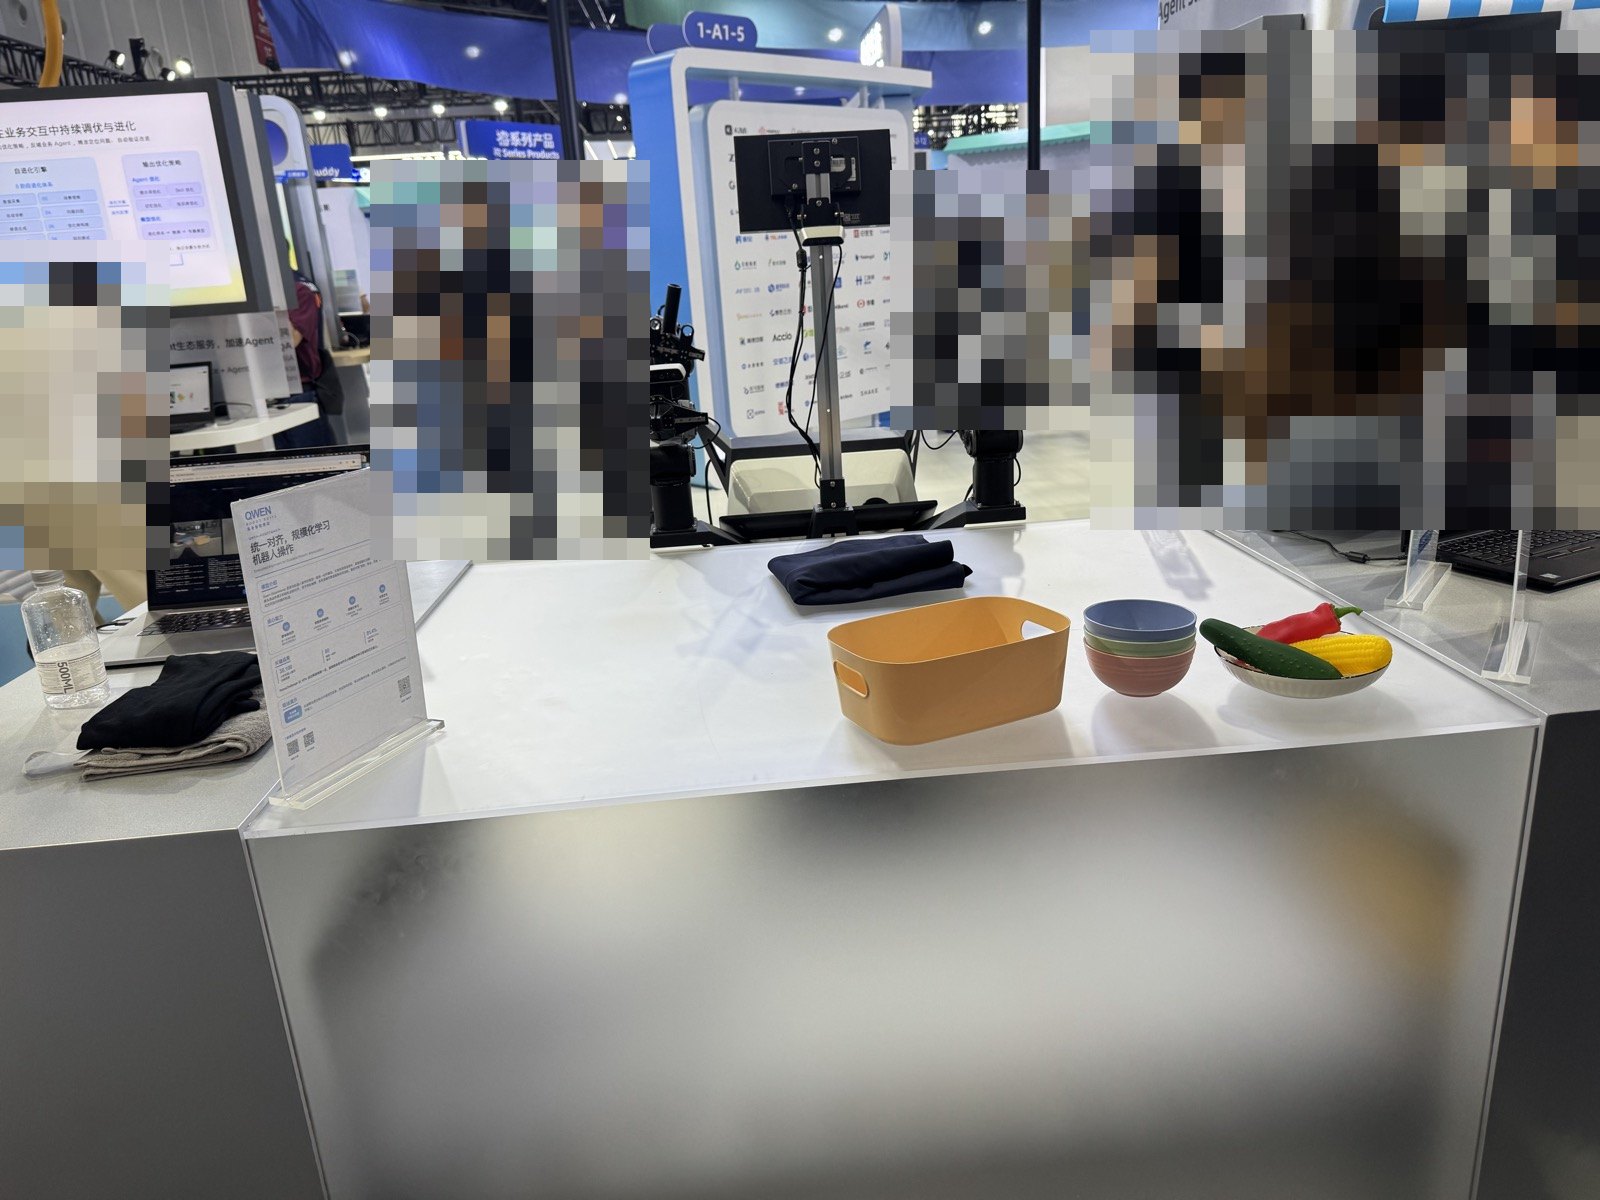
世界モデルが「映像の中の世界」を扱うとすれば、ロボットは実物の世界を扱います。会場の一角に、二本のロボットアームを据えた展示台がありました。アームの間には縦長の支柱とモニター、アームの先端近くにはカメラが付いています。台の上には畳んだ紺色の布、オレンジ色のかご、色違いで重ねたお椀、皿に盛ったキュウリ・パプリカ・トウモロコシの模型。片付けや仕分けを試すための小道具です。撮影した時点でアームが動いている記録はなく、実演の様子や成否は記録していません。
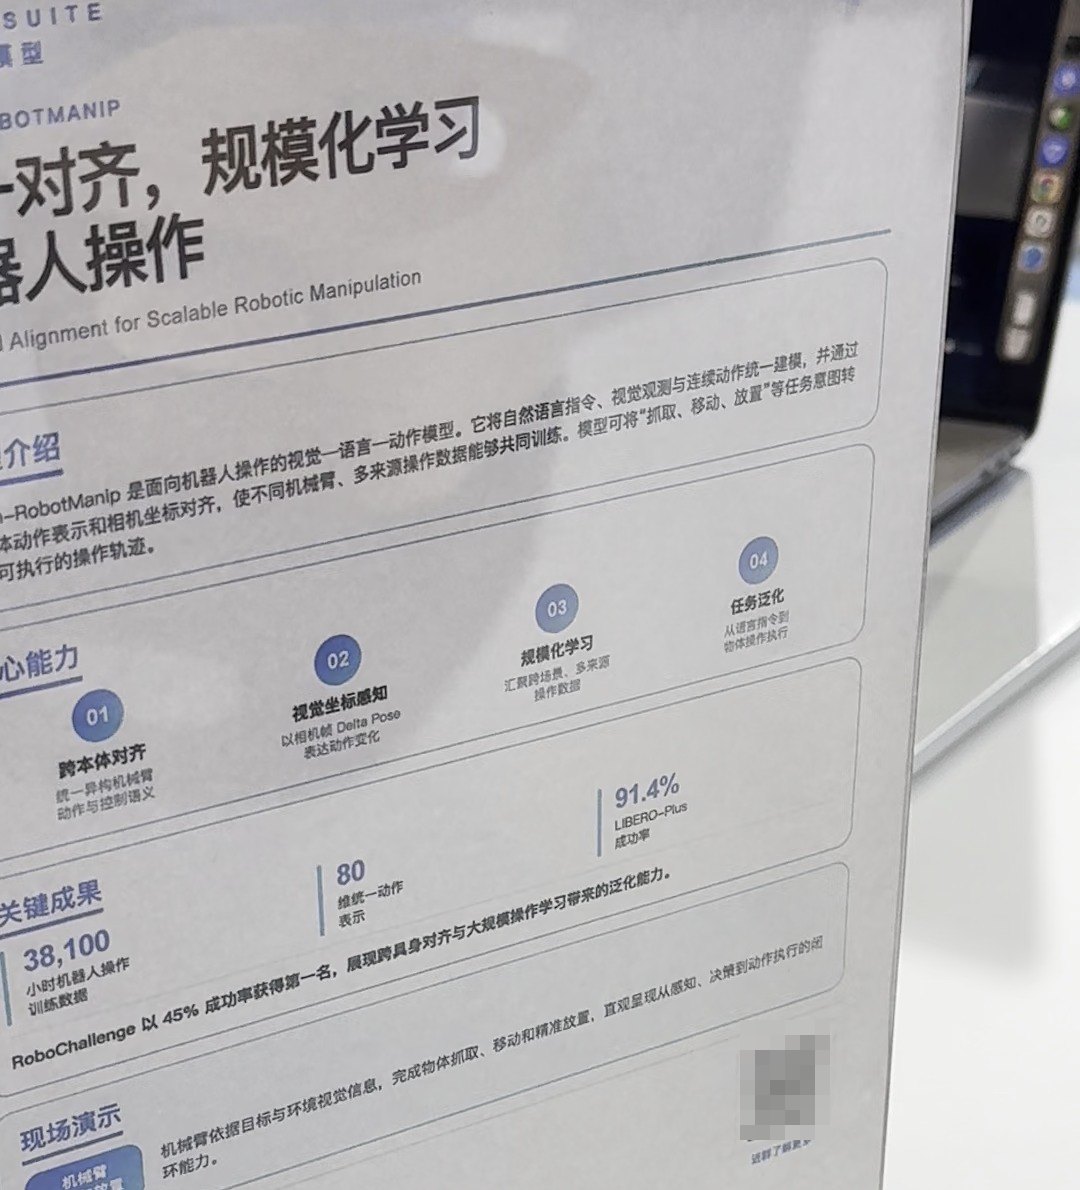
台の端に置かれた卓上パネルには「QWEN ROBOT SUITE」のロゴがあり、見出しは「统一对齐,规模化学习机器人操作」、英語で「Embodied Alignment for Scalable Robotic Manipulation」でした。「揃えて、大規模に、ロボットの操作を学ぶ」といった意味です。
本文の説明を訳すと、おおよそ次のとおりです。Qwen-RobotManipは、ロボットの操作を対象にした「視覚・言語・動作」のモデルである。自然言語の指示、カメラの映像、連続的な動作を一つのモデルで扱い、動作の表し方とカメラの座標系を揃えることで、種類の違うロボットアームや、出どころの違う操作データを一緒に学習できる。モデルは「つかむ」「動かす」「置く」といった作業の意図を、実行できる軌道に変える。
中核の機能として四つが挙げられていました。一つめは「異なる機体の揃え込み」で、構造の違うアームの動作と制御の意味を統一すること。二つめは「視覚座標での感知」で、カメラから見た座標で動きの変化量(Delta Pose)を表すこと。三つめは「大規模学習」で、多くの場面と出どころの操作データを集めること。四つめは「作業の汎化」で、言葉の指示から物体の操作まで通すことです。
「主な成果」の欄には数字が並んでいました。3万8100時間のロボット操作の学習データ、80次元の統一した動作表現、LIBERO-Plusというベンチマークでの成功率91.4%、そしてRoboChallengeで成功率45%で1位になったという記載です。最後の「現場実演」の欄には「アームが目標と周囲の映像をもとに、物体をつかみ、動かし、正確に置く。感知から判断、動作の実行までの一巡を見せる」とありました。短い動画には、パネルの奥のノートPCに三つのカメラ映像と文字のログが並ぶ画面が映っています。
これらの数字は、いずれもパネルに書かれた展示側の主張です。Qwen-RobotManipの公式の技術文書や、LIBERO-PlusとRoboChallengeの結果表は今回の調査で原文を取得できておらず、数字は確認できていません。RoboChallengeのサイトは取得できたものの、本文が画面上で後から読み込まれる作りで、順位の記載を保存できませんでした。
それでも、このパネルが何を解こうとしているかは読み取れます。ロボットの学習で昔から難しいのは、データが機体ごとに分かれてしまうことです。関節の数や長さが違えば、同じ「コップをつかむ」でも関節角度の記録はまったく別物になります。パネルの説明にある「カメラから見た座標で変化量を表す」という方法は、機体の違いを動作の表し方の段階で吸収し、別々の機体で集めたデータを同じ棚に並べるための工夫と読めます。3万8100時間という量は、それがうまくいけば初めて意味を持つ数字です。
言葉で機械を動かす「Device Agent」
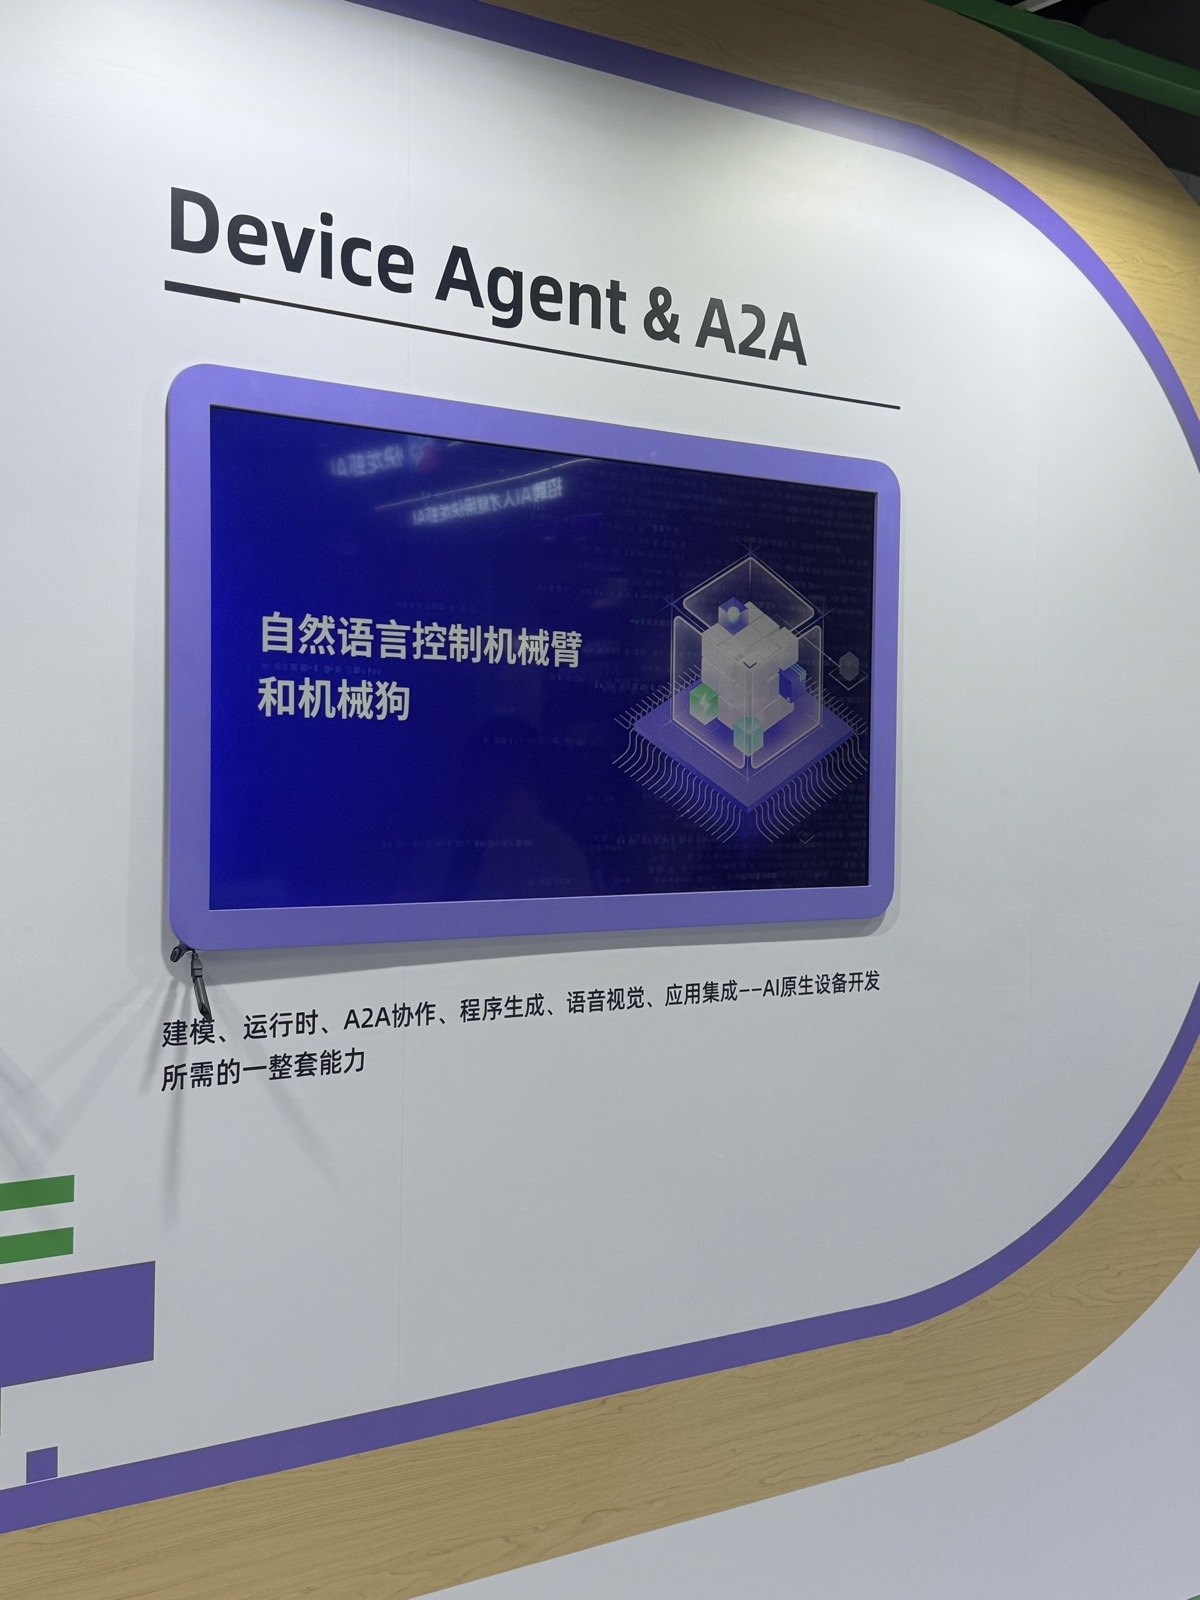
ロボットに関わる展示は、別の形でもありました。「Device Agent & A2A」と題した壁面の画面には「自然语言控制机械臂和机械狗」、つまり「自然言語でロボットアームとロボット犬を操作する」と大きく表示されていました。画面の下には「モデル化、実行環境、A2Aでの連携、プログラム生成、音声と視覚、アプリとの統合。AIネイティブな機器開発に必要な一式の能力」と書かれています。写真にはロボットそのものは写っておらず、実際に何かが言葉で動いた場面の記録はありません。
A2Aは、エージェント同士が互いに仕事を依頼し合うための通信の取り決めです。公開されているA2Aプロトコルのサイトでは「中身が見えないエージェント型アプリケーション同士の通信と相互運用を可能にする、オープンなプロトコル」と説明され、ツールやデータへの接続を担うMCPと、他のエージェントとの接続を担うA2Aを組み合わせて使う位置づけが示されています。
先ほどのRobotManipと、このDevice Agentは、同じ「言葉でロボットを動かす」という話に見えて、層が違います。RobotManipは、カメラ映像と指示から関節の軌道を直接出すモデルでした。Device Agentの説明に並ぶ「プログラム生成」「アプリとの統合」「A2Aでの連携」は、機器の外側でエージェントが手順を組み立て、機器の機能を呼び出す仕組みを思わせます。展示の説明だけでは中の構成はわかりませんが、筆者は、この二つは競合するものではなく、上下に重なるものと見ています。上の層で「棚の在庫を確認して、足りない部品を運ぶ」という段取りを組み、下の層で「この部品をつかんで箱に入れる」という動作を実行する。そういう分担です。
この分担が現実になった場合、ロボットの導入で問われることも変わります。これまでの産業用ロボットは、動作を一つずつ教え込む作業が導入費用の大きな部分を占めてきました。上の層を言葉で組めるようになれば、段取りを変える費用は下がります。その代わりに、言葉の指示が誤解されたときにどこで止めるか、誰が確認するかという設計の比重が増えます。機械の手足が物を壊しうる以上、画面の中のエージェントよりも止め方の設計が重くなるはずです。
ロボットの学習データはどこで作るのか
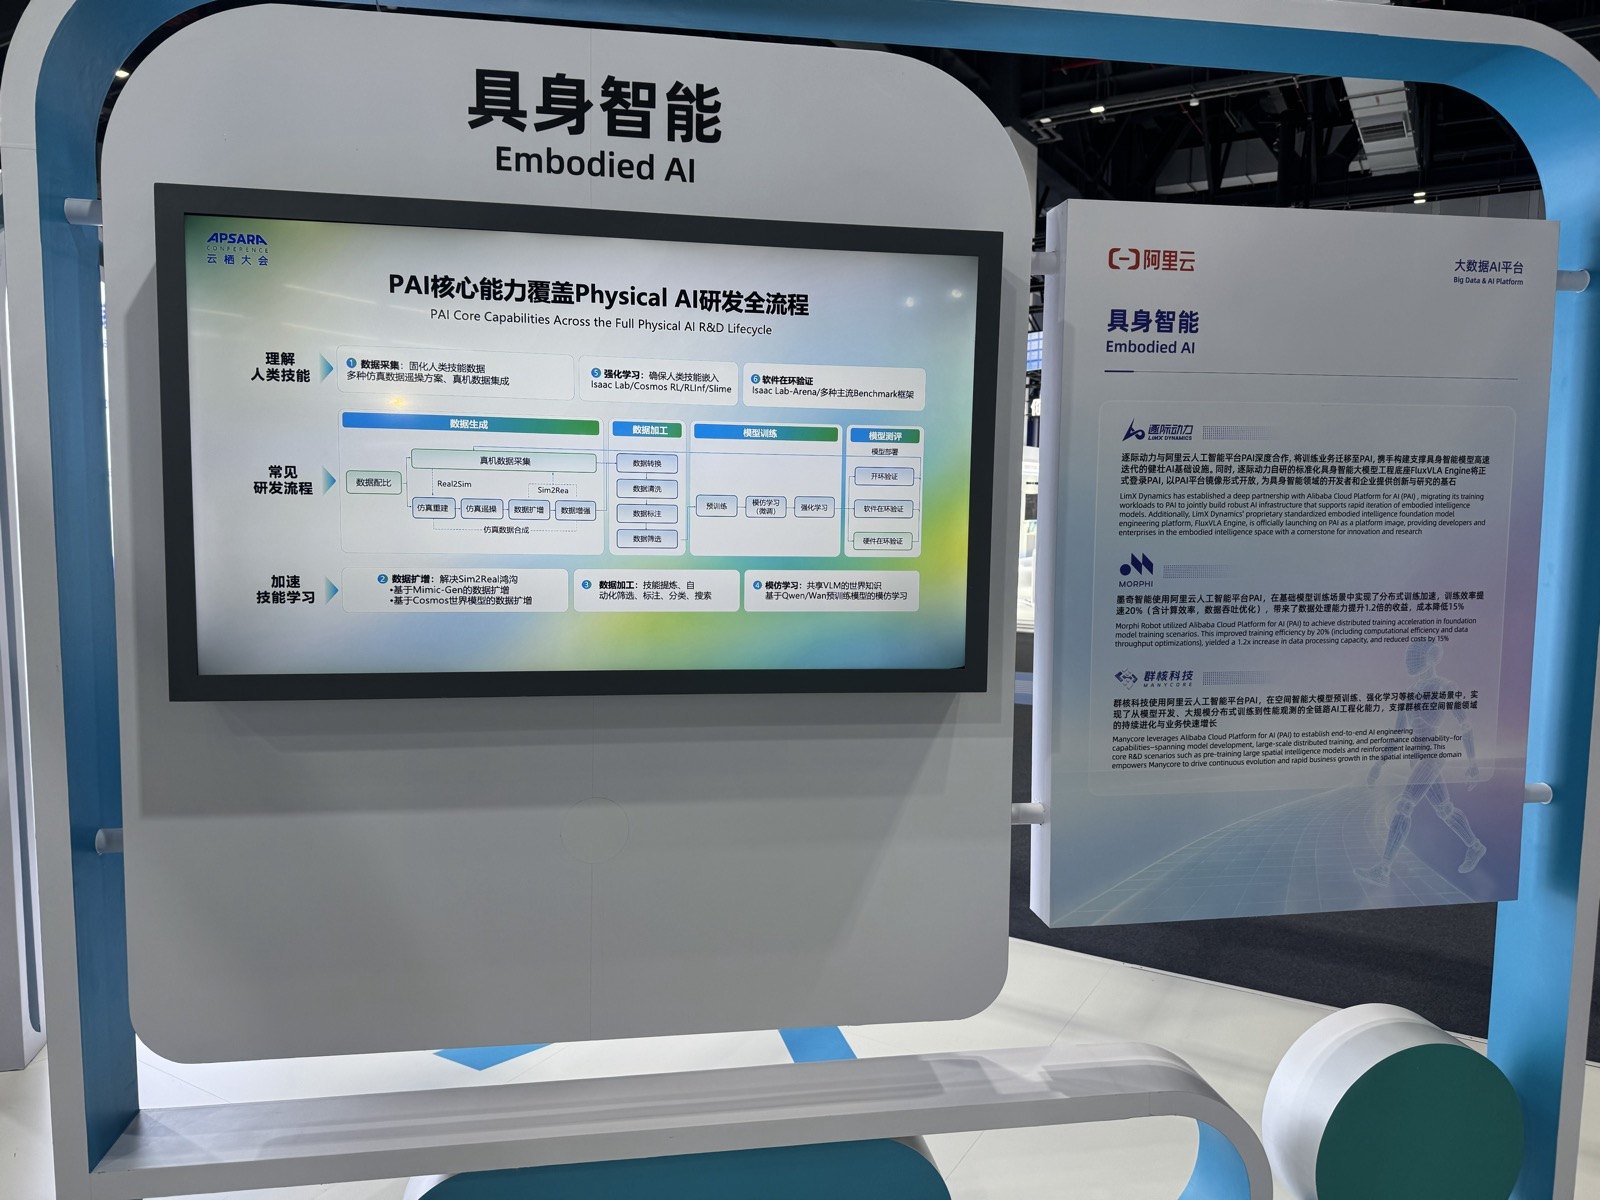
大量のロボット操作データを誰がどう作るのか。その答えの一つを示していたのが、アリババクラウドの機械学習基盤PAIの「具身智能(Embodied AI、身体を持つAI)」展示です。画面の見出しは「PAI核心能力覆盖Physical AI研发全流程」、つまり「PAIの中核機能がPhysical AIの研究開発の全工程を覆う」。
図は三段になっていました。上段は「人の技能を理解する」段階で、データ収集(人の技能データを固める。複数のシミュレーションと遠隔操作の方式、実機データの統合)、強化学習(人の技能の埋め込みを確実にする。Isaac Lab、Cosmos RL、RLinf、Slime)、ソフトウェアでの検証(Isaac Lab-Arenaと主要なベンチマーク)。中段は「一般的な開発の流れ」で、データの生成、加工、学習、評価が左から右に並びます。データ生成の枠の中には、実機データの収集に加えて、シミュレーションの再構築、シミュレーション上の遠隔操作、データの拡張と増強、そして「Real2Sim」「Sim2Real」の矢印が描かれていました。下段は「技能の学習を速める」段階で、データの拡張(シミュレーションと実機の差を埋める。Mimic-Genによる拡張、Cosmos世界モデルによる拡張)、データの加工(技能の抽出、自動の選別・注釈・分類・検索)、模倣学習(VLMの世界知識を共有し、Qwen/Wanの事前学習済みモデルで模倣学習する)です。
図に出てくる外部の道具は、どれも公開されている研究・開発用のものです。MimicGenは、NVIDIAとテキサス大学オースティン校などの研究者による「人の実演データを元にロボット学習用のデータを大規模に生成する仕組み」で、2023年のCoRLで発表されています。NVIDIA Cosmosは、公式のGitHubで「Physical AIシステムの開発を速めるための世界基盤モデルのプラットフォーム」と説明されています。Isaac Labは、NVIDIAのロボット学習用フレームワークで、公式文書にはシミュレーションで学習した方策を実機に移す手順の章があります。
この図には、世界モデルがもう一度出てきます。Happy Oysterの展示では、世界モデルは人が操作して楽しむ製品でした。PAIの図では、世界モデル(ここではNVIDIAのCosmos)は、ロボットの学習データを増やすための道具として描かれています。実機で1時間分の作業を記録するには、実機と人と1時間がかかります。その記録を元に、照明や物の配置、カメラの角度を変えた場面を世界モデルで作れれば、1時間の実演から何十通りもの学習データが得られます。RTCパネルの「Sim2Realで実機データを増やす」という注記も、同じ考え方を別の角度から書いたものでした。
右側のパネルには、PAIを使っているという企業三社の紹介がありました。逐際動力(LimX Dynamics)が自社の身体性AIの基盤モデル開発基盤「FluxVLA Engine」をPAI上で公開した、墨奇智能(Morphi)が分散学習で学習効率を20%高めた、群核科技(Manycore)が空間知能の大規模モデル開発に使っている、といった内容です。いずれも展示側による紹介で、この記事では各社の発表を確認していません。
「一つの網」で計算とデータを運ぶ
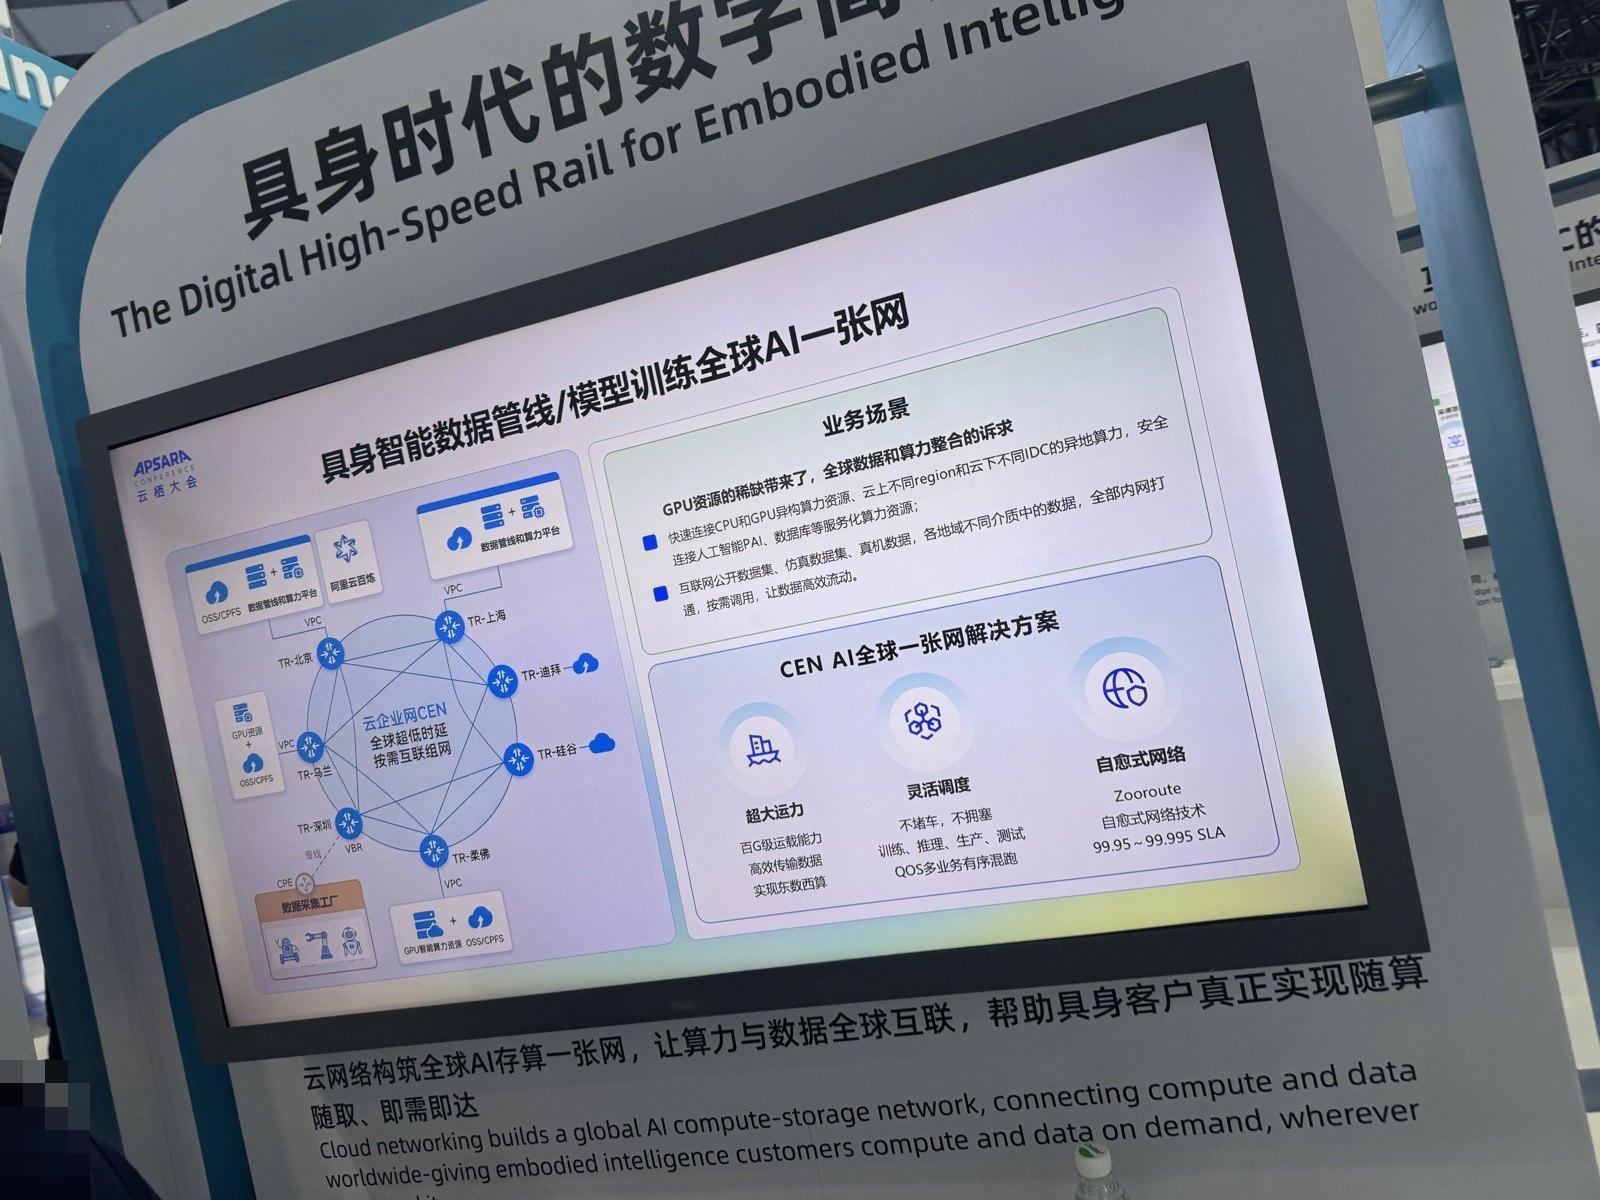
データを作る場所と、学習する場所は、同じとは限りません。ネットワーク区画の展示の一つは、その問題を正面から扱っていました。見出しは「具身时代的数字高速」、英語で「The Digital High-Speed Rail for Embodied Intelligence」。画面の題は「身体性AIのデータパイプラインとモデル学習をつなぐ、世界で一つのAIネットワーク」です。
画面右上の「業務場面」の欄には、「GPU資源の不足が、世界中のデータと計算資源を一つにまとめたいという要求を生んだ」と書かれていました。CPUとGPUの計算資源、クラウドの異なるリージョン、クラウド外の異なるデータセンターを素早くつなぐこと、インターネット上の公開データ、シミュレーションのデータ、実機のデータといった、場所も媒体も違うデータを内部のネットワークで行き来させることが課題として挙がっています。左側の図では、北京・上海・深セン・ドバイ・シリコンバレー・ジョホールバル(柔佛)などの拠点が輪になってつながり、左下に「データ収集工場」と書かれた箱から専用線で接続される様子が描かれていました。解決策の欄には、大容量の伝送、学習・推論・生産・試験を詰まらせずに流す優先制御、「Zooroute」という自己修復型のネットワーク技術と、99.95〜99.995%の稼働率(SLA)という表示があります。
公式文書では、Cloud Enterprise Network(CEN)は「アリババクラウドの私設グローバルネットワーク上で動く高可用のネットワークサービスで、Transit Router(TR)を中継点として、リージョンをまたぐVPC同士や、VPCとオンプレミスのデータセンターの間に私設の経路を作る」と説明されています。展示図の拠点に付いた「TR-北京」「TR-上海」といった表記は、このTransit Routerを指すと読めます。99.95〜99.995%という数字や、Zoorouteの仕組みは、取得した公式文書の範囲では確認できていません。
図には「データ収集工場」という言葉もありました。人が遠隔操作でロボットを動かし、その記録を学習データとして集める拠点のことでしょう。図の上では、その拠点は計算資源とは別の場所にあり、専用線でネットワークに入ってきます。データを作る場所と、GPUがある場所が離れている前提で、網が設計されているわけです。
同じ区画の、別々の三つの展示
同じネットワーク区画には、用途の違う展示がほかにも並んでいました。三つを順に見ますが、これらは別々の展示です。一つのシステムとして組み合わされていたわけではありません。
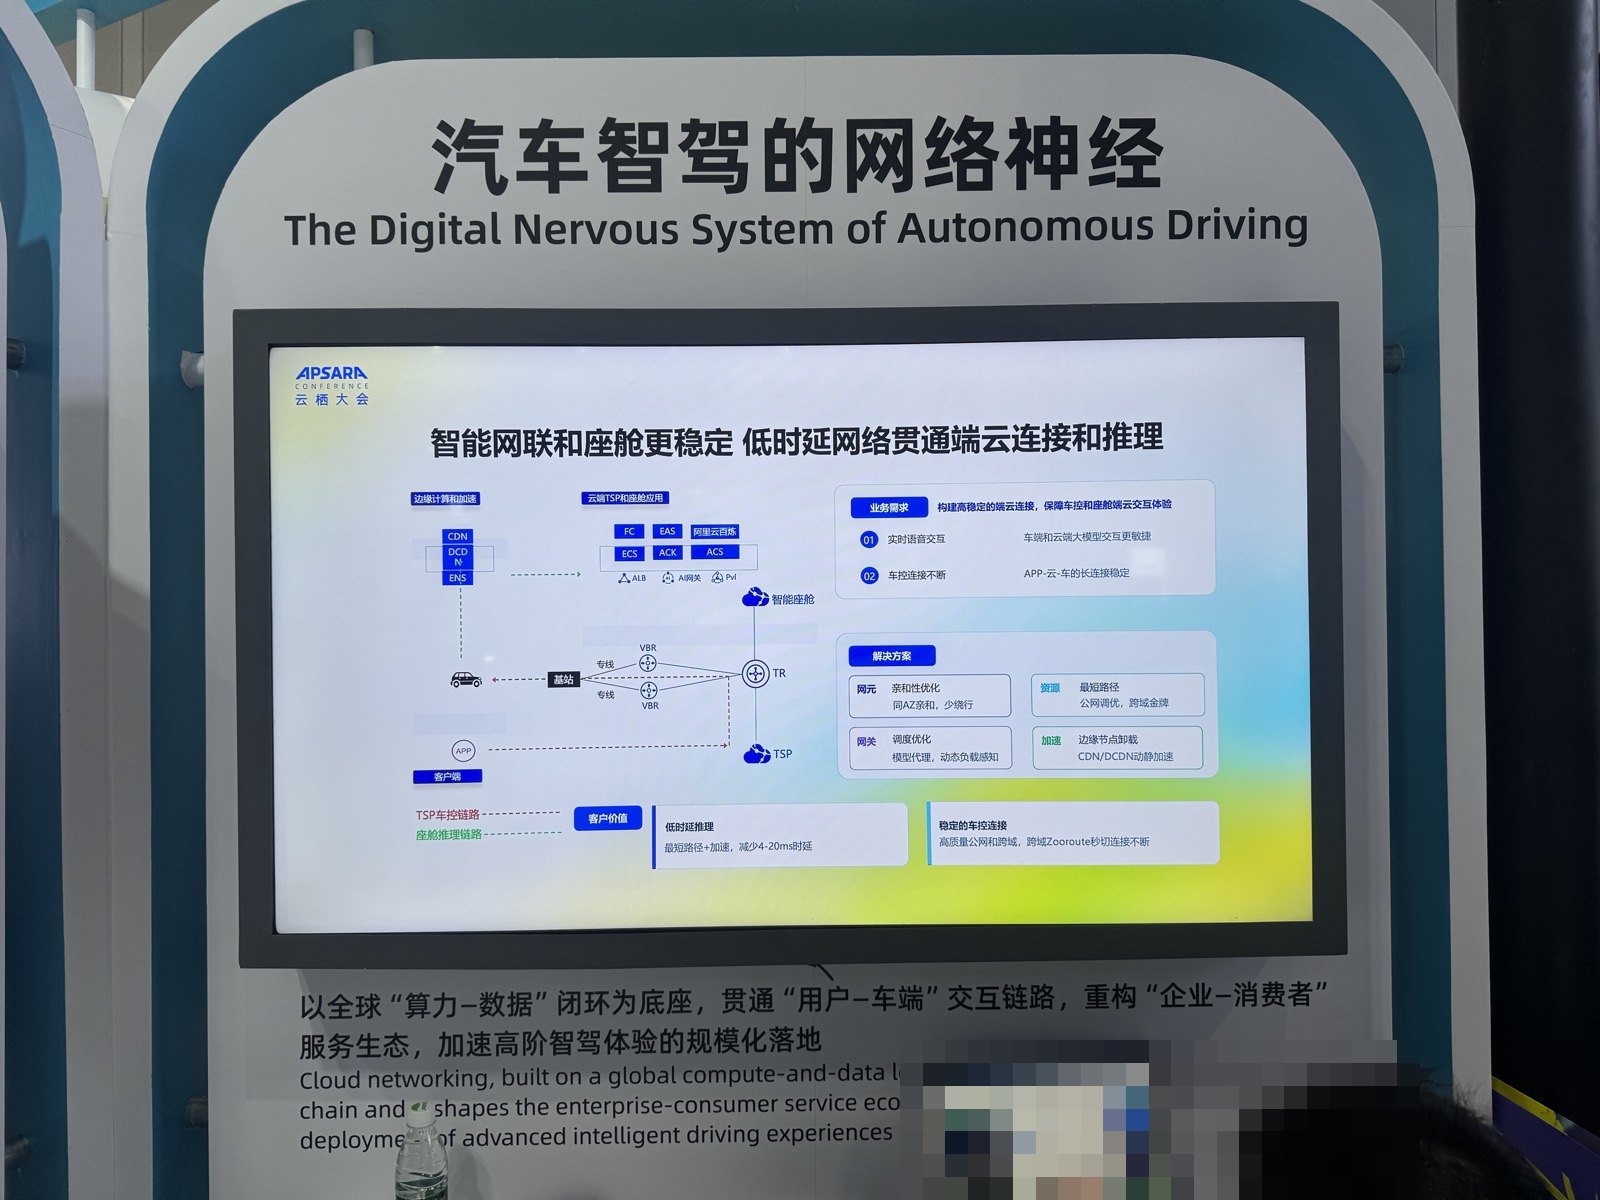
一つめは自動運転です。見出しは「汽车智驾的网络神经」、英語で「The Digital Nervous System of Autonomous Driving」。ここでも「神経」という言葉が使われていました。画面の題は「コネクテッドカーと車内空間をより安定させる。低遅延のネットワークで車とクラウドの接続と推論を貫く」。図の左に、エッジでの計算と加速(CDN、DCDN、ENS)、上にクラウド側の車両管理サービス(TSP)と車内向けアプリの基盤(FC、EAS、ECS、ACK、ACSなど)、中央に車両から基地局、専用線、TRを経てクラウドへ至る経路が描かれています。
業務上の要求として挙がっていたのは二つです。一つは車内でのリアルタイムの音声対話で、車とクラウドの大規模モデルのやり取りをより速くすること。もう一つは車両制御の接続が途切れないことで、アプリ・クラウド・車の長時間の接続を安定させること。顧客にとっての価値の欄には「最短経路と加速で、遅延を4〜20ミリ秒減らす」と書かれていました。これも展示側の表示です。
ここで目を引くのは、「推論」という言葉が車とクラウドの間の経路に置かれている点です。図の中で、クラウドに置かれているのは車両管理と車内の対話機能で、運転の判断そのものではありません。ブレーキやハンドルの判断を毎回クラウドに問い合わせる構成は、展示のどこにも描かれていませんでした。
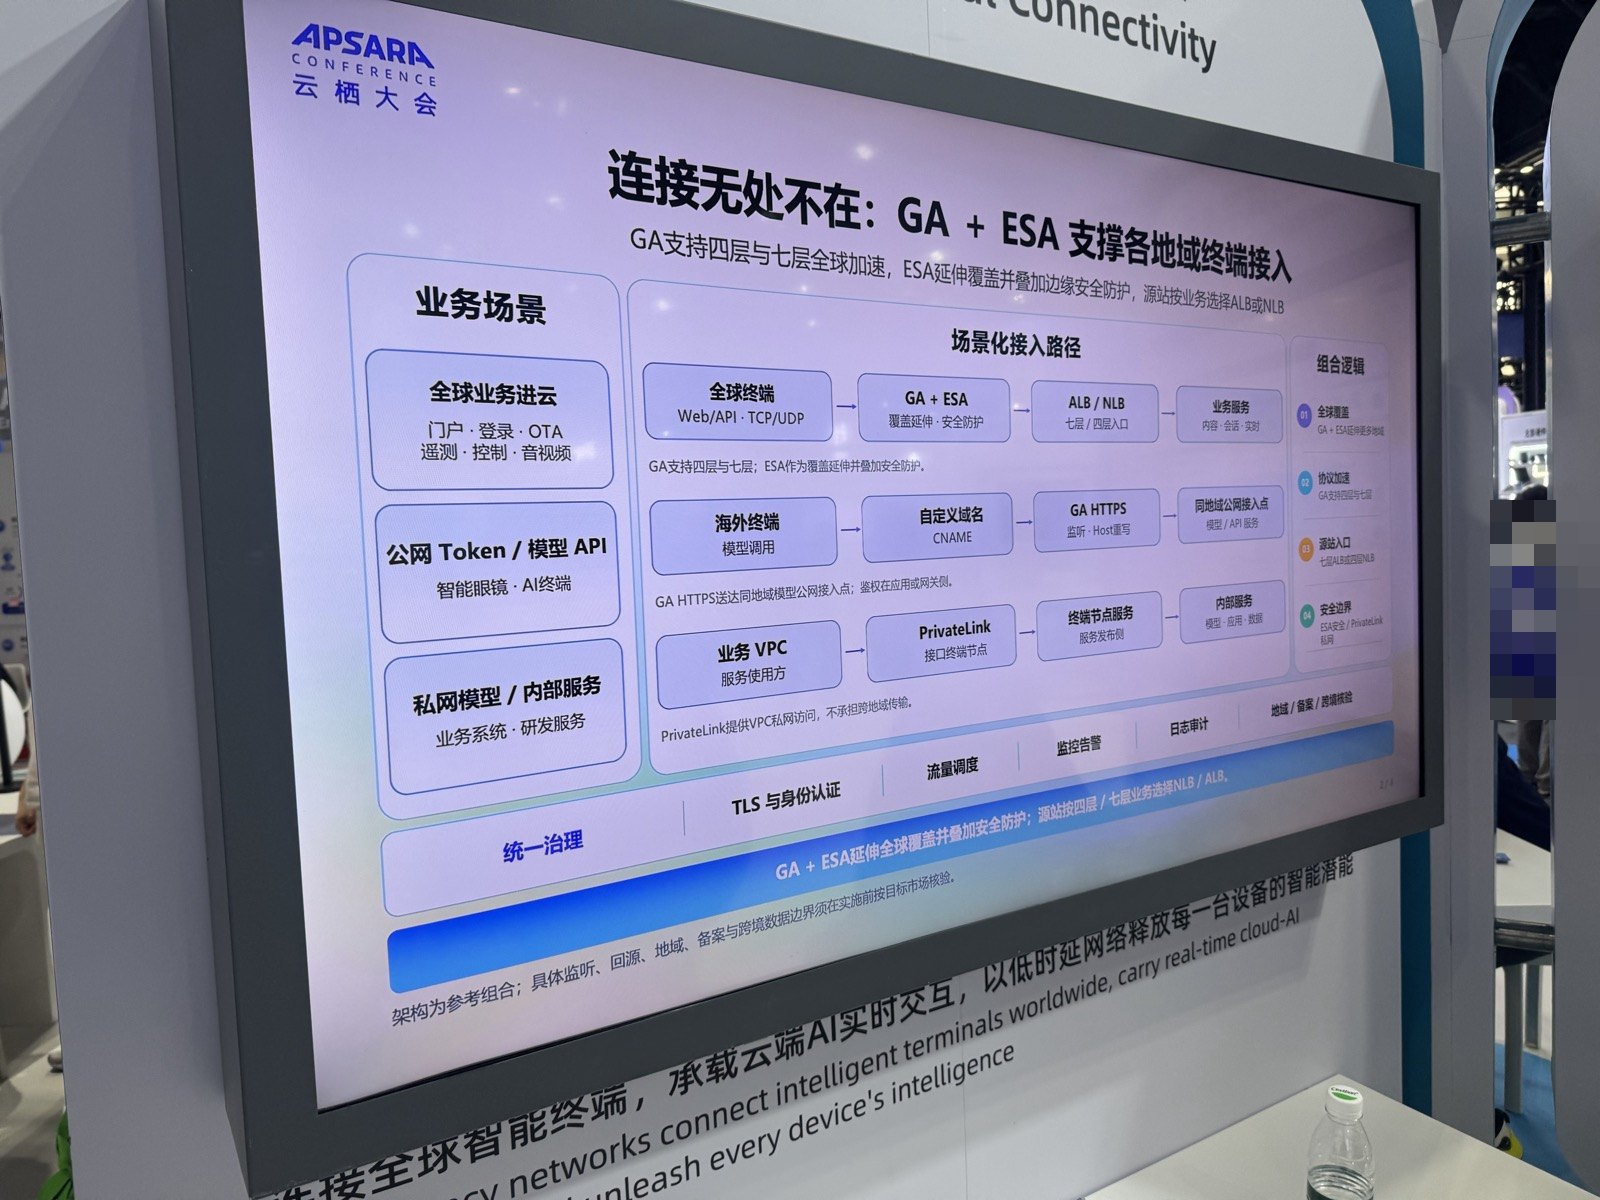
二つめは、世界中の端末をクラウドにつなぐ入口の展示です。題は「どこでもつながる:GAとESAが各地域の端末接続を支える」。業務場面は三つに分けられていました。世界中の業務をクラウドに載せる場合(ポータル、ログイン、OTA更新、遠隔計測、制御、音声・映像)、公開ネットワーク越しにトークンやモデルAPIを使う場合(スマートグラス、AI端末)、そして私設ネットワーク内のモデルや社内サービスの場合(業務システム、研究開発サービス)です。それぞれに、端末からGA(Global Accelerator)とESA(Edge Security Acceleration)を経て、ロードバランサー、業務サービスへ至る経路が描かれていました。
公式文書では、GAは「アリババクラウドの世界規模のBGPネットワークを通じて、最寄りのアクセスポイントへ通信を導き、遅延・揺らぎ・パケット損失を減らすネットワーク加速サービス」で、レイヤー4(TCP/UDP)とレイヤー7(HTTP/HTTPS)の通信を加速すると説明されています。ESAは「インターネット上のコンテンツ、アプリケーション、データセンター、企業ネットワーク、AIワークロードを保護・加速する統合クラウドサービス」で、世界に分散した接続拠点を持つとされています。
この展示で筆者が一番大事だと思ったのは、画面の最下部にあった小さな注記です。「構成は参考の組み合わせである。具体的な受け口、配信元への戻し方、地域、届出(備案)、国境を越えるデータの境界は、実施前に対象市場ごとに確認が必要」。展示自身が、図はそのまま使える設計ではないと断っています。国をまたいで端末とクラウドをつなぐとき、通信の速さより先に、どの国のどの規則に沿うかを決めなければならない。展示はそのことを図の中に明記していました。
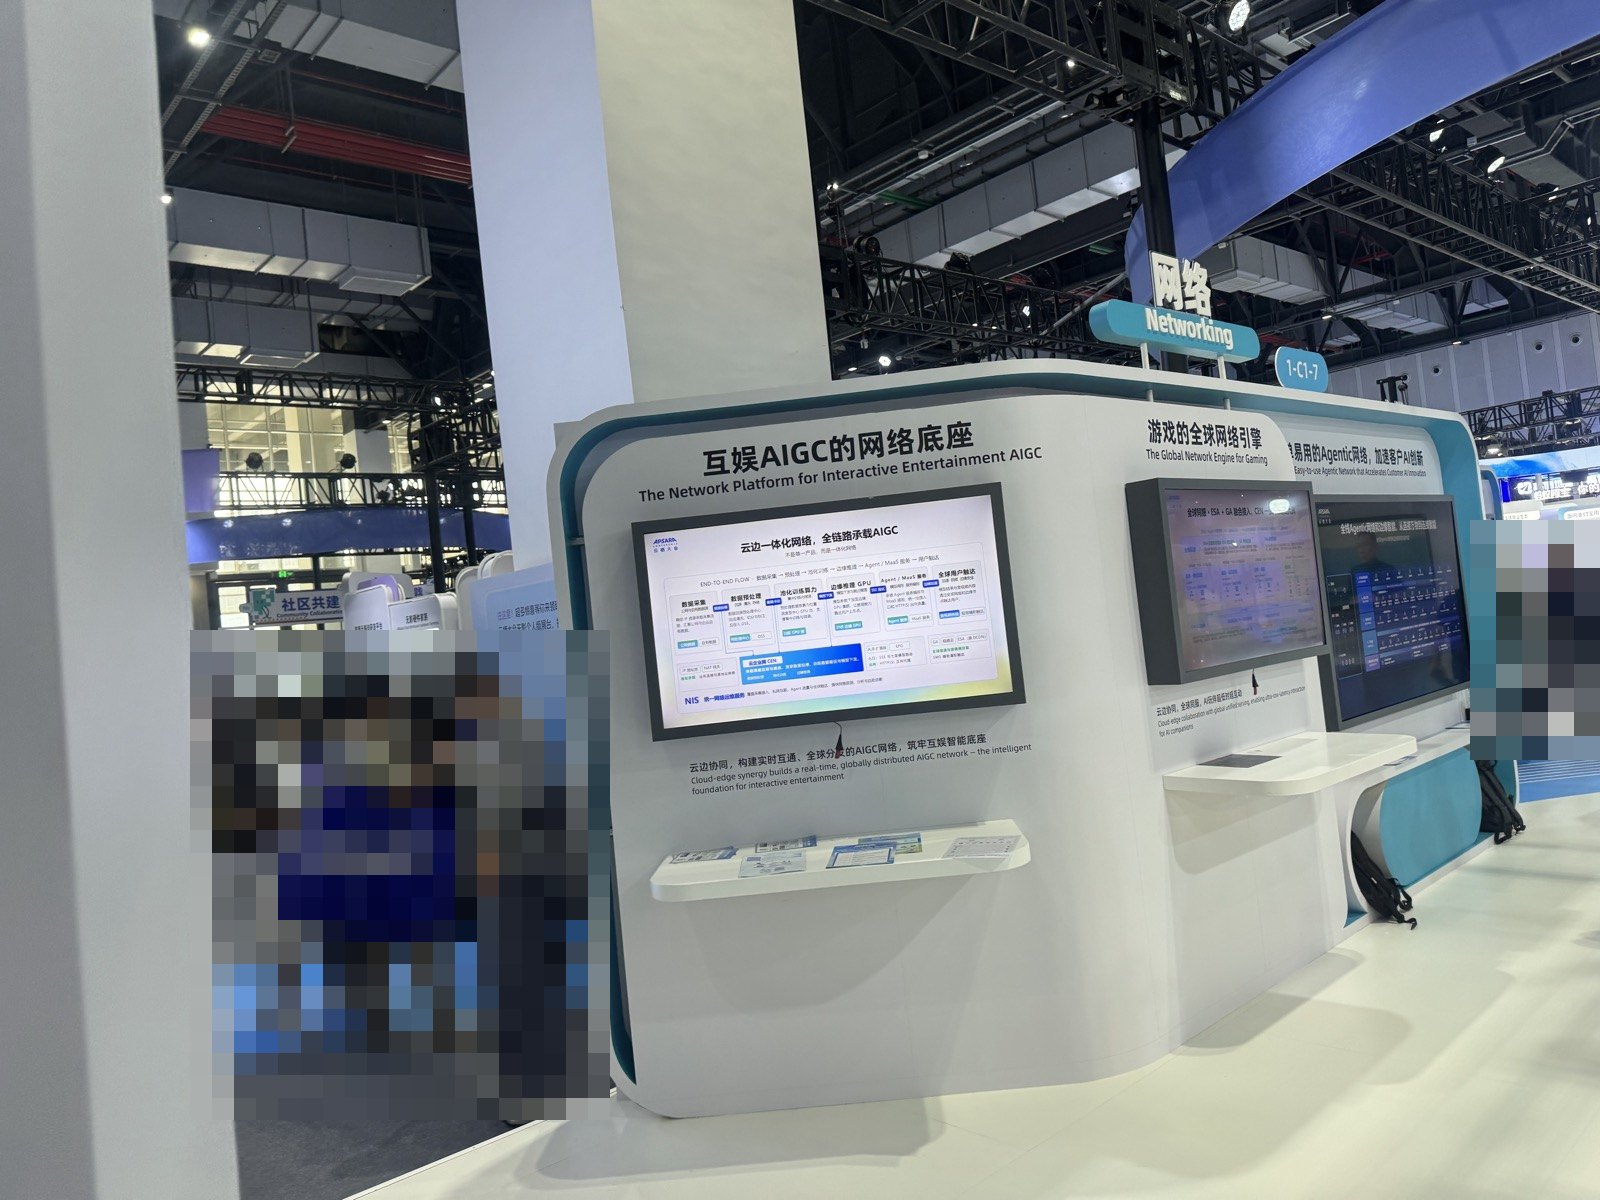
三つめは、ゲームなど対話型の娯楽に使うAIGCのための網です。見出しは「互娱AIGC的网络底座」、英語で「The Network Platform for Interactive Entertainment AIGC」。画面の題は「クラウドとエッジが一体になった網で、AIGCを全経路で運ぶ」。説明文には「クラウドとエッジが協調し、リアルタイムにつながり、世界中に配信するAIGCの網を作る」とありました。画面の細かい図は写真の解像度では読み切れないため、ここでは題と説明文だけを紹介します。
Happy Oysterのように操作に応じて映像を作り続ける製品を世界中の利用者に届けるなら、必要になるのはこうした網です。ただし、会場でHappy Oysterとこの網が結び付けて説明されていたという記録はありません。つながりは筆者の推測です。
遅延は何を決めるのか
ここまでの展示を並べると、共通する言葉がいくつもあります。「神経系」「低遅延」「エッジ」「優先度」。そして、どの展示も「どこで計算するか」をはっきりさせていました。この点から、遅延が何を決めるのかを考えてみます。
ロボットや車の制御には、時間の長さの違うループが何重にもあります。モーターの電流や関節の角度を整えるループは、機械の中で千分の一秒単位で回ります。物をつかむ、よける、といった判断は、数十から数百ミリ秒で回ります。今日の作業の段取りを組む、学習し直す、といったループは、数分から数日です。通信の遅延がどのループに入り込むかで、それをクラウドに任せられるかどうかが決まります。
RTCパネルにあった「力覚フィードバックは20ミリ秒未満」という表示は、遠隔操作で人の手に反力を返すループの話です。人が機械越しに物に触れる感覚を得るには、この程度の速さが要るというのが展示の主張でした。一方、公式の製品ページが示す音声・映像通話の遅延は「最短150ミリ秒」です。映像を見ながら指示を出すことはできても、触った感触を返すには足りない。二つの数字の差は、そのまま「どのループをネットワーク越しに回せるか」の差だと読めます。
自動運転の展示も、同じ考え方で描かれていました。クラウドに置かれていたのは、車内の対話と車両管理です。数ミリ秒を争う判断は車の中に残し、数百ミリ秒かかってもよい対話と、途切れてはいけないが即時でなくてよい管理をネットワークに乗せる。展示の「4〜20ミリ秒減らす」という数字は、主に対話の体感を良くするためのものと読むのが自然です。
世界モデルの配信も同じ見方で考えられます。キーを押してから画面が変わるまでに、生成の時間と伝送の時間がかかります。何ミリ秒までなら遅れを感じないかは、操作の種類や人によって違い、この記事では基準となる数字を確認していません。ただ、許される時間の総量が決まっている以上、生成に使える時間を増やすには伝送を削るしかありません。「一枚生成したら一枚送る、差分だけを送る」という注記は、その削り方の説明でした。
ここから、条件付きの予測を三つ述べます。
一つめ。遠隔操作と学習データの収集は、Physical AIの中でネットワークへの依存が最も早く深まる分野になると考えます。ロボットが自律的に動けるようになるまでの間、人が遠隔で操作し、その記録を学習データにする形が続くからです。PAIの図にある「遠隔操作の方式」、CENの図にある「データ収集工場」、RTCパネルの「遠隔操作とデータ収集」は、いずれもこの形を前提にしていました。ただしこれは、遠隔操作で集めたデータが実際に学習に役立つ、という前提が崩れない場合の話です。シミュレーションだけで十分なデータが作れるようになれば、実機の遠隔操作の比重は下がります。
二つめ。制御の中核は、今後数年は機械の中とすぐ近くのエッジに残ると考えます。会場の展示は、どれも即時の判断をクラウドに置いていませんでした。通信事業者の網が極端に速くなるか、ロボットの停止を安全に設計できる用途が広がらない限り、この配置は大きくは変わらないでしょう。
三つめ。クラウドが担う役割は、「判断する場所」から「学習し、データを増やし、段取りを組む場所」へと広がると見ています。世界モデルによるデータの増強、機体をまたいだ操作データの統合、言葉で段取りを組むエージェント。会場で見た展示の多くは、この役割に当てはまります。この予測は、ロボットを使う現場のデータをクラウドに送ってよいかどうか、という制約に強く左右されます。
日本企業の仕事への影響
日本の製造業や物流、インフラの現場から見ると、今回の展示から読み取れることがいくつかあります。
まず、ロボット導入の費用の内訳が変わるかもしれません。これまでは、ロボットに動作を教える作業と、周辺の治具や安全柵の設計が大きな比重を占めてきました。言葉の指示を軌道に変えるモデルや、段取りを組むエージェントが実用になれば、教え込みの費用は下がるかもしれません。その代わりに、どの作業のデータを、誰が、どの程度の品質で集めるかという仕事が増えます。熟練者の手つきを遠隔操作で記録し、学習データにするという発想は、日本の現場に多い「言葉にしにくい技能」をどう扱うかという課題と直接つながります。
次に、データの置き場所の問題です。GAとESAの展示の注記にあったように、国をまたぐ構成では、地域ごとの届出や、国境を越えるデータの扱いを事前に確かめる必要があります。日本企業が中国や東南アジアに工場や拠点を持ち、現地のクラウドと日本の本社のシステムをつなぐ場合、ロボットの操作データや工場の映像がどの国に保存され、どこで学習に使われるかは、技術の選択より先に決めなければならない事項です。
三つめに、遅延の要件を用途ごとに書き分ける必要が出てきます。RTCパネルが示したように、遠隔操作の力覚、自動運転の対話、工場のデジタルツインの同期、ドローンの弱電波では、求められる通信の性質が違います。「低遅延なクラウド」という一言で調達や評価をすると、肝心の要件を見落とします。どのループをどこで回すのか、何ミリ秒までなら許されるのか、途切れたらどう止まるのか。導入の前に、これを業務の側から書き出しておく必要があります。
最後に、世界モデルは、ロボットより先に制作や研修、設計の確認といった画面の中の仕事に入ってくるはずです。操作に応じて場面が変わる仮想空間は、設備の配置を試す、作業手順を研修で体験する、といった用途に向いています。ただし、Happy Oysterの公式サイトが示すのは娯楽と創作の機能で、産業用途での精度や物理的な正しさは確認されていません。業務に使うなら、どの程度の正確さが要るのかを先に決めることになります。
Physical AIの導入検討で当社が重視すること
当社は、海外の技術と日本の現場の知見をつなぎ、AIに仕事を任せられる状態をつくることを目指しています。Physical AIと世界モデルの分野では、今回の展示を踏まえ、次の三点を重視しています。
一つは、評価と選定の支援です。ロボット向けのモデル、学習基盤、通信の選択肢は、展示を見ただけでも国内外に数多くあります。展示の数字は展示側の主張で、公式文書で確かめられる範囲は限られていました。今回の記事で試みたように、展示の主張と公式文書の記載と未確認の点を分けて整理し、自社の用途に照らして比較できる形にすることが、選定の出発点になります。
二つめは、遅延と停止の要件を業務の言葉で書き出すことです。どの判断を現場の機械に残し、どれをクラウドに任せるのか。通信が途切れたとき、指示が誤解されたとき、誰がどう止めるのか。技術の選定より前に、これを現場の方と一緒に言葉にする作業が必要です。
三つめは、現場の知見をデータとして残し、使い回せるようにすることです。熟練者の操作記録、作業の段取り、失敗した事例。こうした知見は、ロボットの学習データにも、エージェントに段取りを任せる際の手順書にもなります。会場で見た「データ収集工場」という発想を、日本の現場の規模と規則に合う形で試せないか。その検討を、導入後の継続的な見直しまで含めて支えることを目指しています。
まとめ
会場で見た世界モデルとPhysical AIの展示は、モデルの賢さより、つなぎ方の話をしていました。操作に応じて場面を作り続けるHappy Oyster、機体の違いを揃えて操作を学ぶRobotManip、言葉で機械を動かすDevice Agent、データを作り増やすPAI、そして用途ごとに困りごとの違う通信の網。それぞれの展示が「どこで計算し、何をどれだけ速く届けるか」を別々の言葉で説明していました。
生成と操作の違いは、成果物がファイルか、続いていく状態かの違いです。そして、続いていく状態を人や機械に届けるとき、遅延が使い道の範囲を決めます。展示の数字の多くは未確認ですが、その問いの立て方は、日本の現場でAIに仕事を任せるときにもそのまま使えるはずです。
出典
- [S1] アリババクラウド「音视频通信RTC」製品ページ https://www.aliyun.com/product/rtc (2026-09-27取得)
- [S2] Happy Oyster(快乐生蚝)公式サイト https://happyoyster.cn/ (2026-09-27取得、運営主体は未確認)
- [S3] Alibaba Cloud「What is Cloud Enterprise Network?」 https://www.alibabacloud.com/help/en/cen/product-overview/what-is-cen (2026-09-27取得)
- [S4] Alibaba Cloud「What is Global Accelerator?」 https://www.alibabacloud.com/help/en/ga/product-overview/what-is-global-accelerator (2026-09-27取得)
- [S5] Alibaba Cloud「What is ESA?」 https://www.alibabacloud.com/help/en/edge-security-acceleration/esa/product-overview/what-is-esa (2026-09-27取得)
- [S6] A2A Protocol https://a2a-protocol.org/latest/ (2026-09-27取得)
- [S7] MimicGen プロジェクトページ https://mimicgen.github.io/ (2026-09-27取得)
- [S8] NVIDIA Cosmos(GitHub組織ページ) https://github.com/nvidia-cosmos (2026-09-27取得)
- [S9] Isaac Lab Documentation https://isaac-sim.github.io/IsaacLab/main/index.html (2026-09-27取得)
記事情報
| 取材・執筆・編集 | 株式会社Metelix |
|---|---|
| 公開日 | |
| 最終更新日 | |
| 分類 | 解説(Apsara 2026・世界モデル・Physical AI) |
| 利害関係 | 本記事は、Apsara Conference 2026の展示と公開文書をMetelixが取材・編集した技術解説です。数値は特に断りのない限りベンダー提示値であり、Metelixによる測定値ではありません。 |
| 検証方法 | 公開文書の記述は、2026年9月25日(日本時間)に公式サイト・公式ヘルプから取得し、製品名・機能名・数値などの主要な記述が公開文書に含まれることを確認しました。展示の記述は2026年9月の現地取材で確認した提示内容で、測定条件は示されていません。 |
| 評価時点 | 展示の取材は2026年9月(杭州・現地)。公開文書の閲覧日は2026年9月25日(日本時間)。内容と提供段階は閲覧時点のもので、今後変わる可能性があります。 |
関連記事
- 2026.09.26|解説AIエージェント基盤を読み解く、6つの視点:Apsara Conference 2026 技術解説シリーズ
- 2026.09.26|解説AI端末・ワークスペース編:Qwen BookからクラウドPC、ウェアラブルまで
- 2026.09.26|解説画像・動画生成編:制作業務に生成モデルをどう組み込むか
改訂履歴
| 初版公開 | |
| 写真説明を更新 |