Apsara Conference 2026(2026年9月22〜24日、杭州)の会場で、画像と動画を作る生成モデルは複数の場所に出ていました。大型モニターの紹介映像、立て看板つきのモデル展示、作例を流すギャラリー、そして講演のスライドです。この記事では、撮影した写真と動画に写っていたものを順にたどり、展示が何を伝えようとしていたのかを読み解きます。そのうえで、公開されている API 文書から「制作の現場で何を指定できるのか」を補い、日本の企業が制作業務に組み込むときに何が変わりそうかを考えます。
先に断っておくと、会場で生成を実行している画面は記録できていません。以下は、展示の画面・パネル・スライドの記録と、2026年9月27日に取得した公式文書にもとづく読み物です。
大型画面に並んだ三つのカード
写真・動画:「Multimodal Model」と題した大型モニターの画面。三枚のカードの上部の作例映像が数秒ごとに切り替わる。
最初に取り上げるのは、「Multimodal Model」と見出しのついた大型モニターです。撮影した約55秒の動画のあいだ、画面には三枚のカードが並んだまま、それぞれの上部の作例映像だけが数秒おきに入れ替わっていました。
左のカードは「Wan」で、副題は「Image and Video Generation(画像と動画の生成)」です。中央は「HappyHorse」で「Video Generation(動画生成)」、右は「Happy Oyster」で「World Model(世界モデル)」とあります。三つとも Alibaba 系のモデルの名前です。
カードの下半分には、それぞれの特徴が英語の短い句で四つずつ書かれていました。Wan には「Precise Facial Feature Control(顔の特徴を細かく制御)」「Free-form Video Instruction Editing(自由な指示による動画の編集)」「Ultra-long Text Rendering(長い文字列の描画)」「Controllable Multimodal Creation(制御できるマルチモーダル生成)」。HappyHorse には「Precise Intent Following(意図に正確に従う)」「Cinematic and Aesthetic Visuals(映画的で美しい映像)」「Consistent and Accurate Physics(一貫した正確な物理表現)」「Lifelike and Emotional Characters(生き生きとして感情のある人物)」。
Happy Oyster だけは書き方が違い、「Generates complete, interactive, and explorable AI virtual worlds(完結した、操作でき、歩き回れる AI の仮想世界を生成する)」という一文のあとに、「Text-to-World Generation(テキストから世界を生成)」「Free Roaming, Any Style(自由に移動、任意の画風)」「Real-Time Interactive Streaming(リアルタイムの対話的な配信)」「Custom Physics & Co-Creation(物理法則の設定と共同制作)」と続きます。作例の画面の左右には、ゲームの操作キーのような矢印のアイコンが重ねてありました。
この並べ方がまず面白いところです。Wan と HappyHorse の特徴は「どれだけ思いどおりの一本を作れるか」に集中しています。顔、文字、指示への忠実さ、物理の破綻のなさ。どれも、一本の映像を納品物として仕上げるときに問われる点です。これに対して Happy Oyster は、見る人が操作して場面が変わり続けるものとして説明されています。同じ「映像を作るモデル」の棚に置かれていても、動画生成は完成品を作る道具、世界モデルは操作に反応し続ける環境を作る道具です。この記事では前者を扱い、世界モデルは同じ連載の世界モデル・Physical AI 編に譲ります。
「No.1」の表示をどう読むか
三枚のカードには、どれも大きく「NO.1」と書かれていました。Wan のカードは「Ranked #1 on DesignArena's Video-to-Video Leaderboard(2026/4/10)」、HappyHorse のカードは「Ranked #1 on Artificial Analysis for text-to-video & image-to-video(2026/4/07)」です。いずれも、外部の比較サイトで特定の日付に首位だった、という展示側の主張です。
この表示は、性能の証明としては使わないほうが安全です。理由は三つあります。一つは、比較サイトの順位は投票や評価の方式で決まり、日々入れ替わることです。二つめに、部門が限定されています。Wan の表示は「動画から動画」、つまり既存の映像を作り替える部門の順位で、テキストから動画を作る部門の話ではありません。三つめに、今回の調査では両サイトの該当ページの原文を取得できていません。
それでも日付には意味があります。Alibaba Cloud の公式ブログは2026年4月28日付で、HappyHorse 1.0 を限定ベータとして公開すると伝えています。展示の日付はその直前です。順位そのものより、「春に外部の比較で名前が出て、その月のうちに限定公開へ進んだ」という時間の流れのほうが、このモデルの立ち位置をよく表しています。
立て看板の説明文を読む
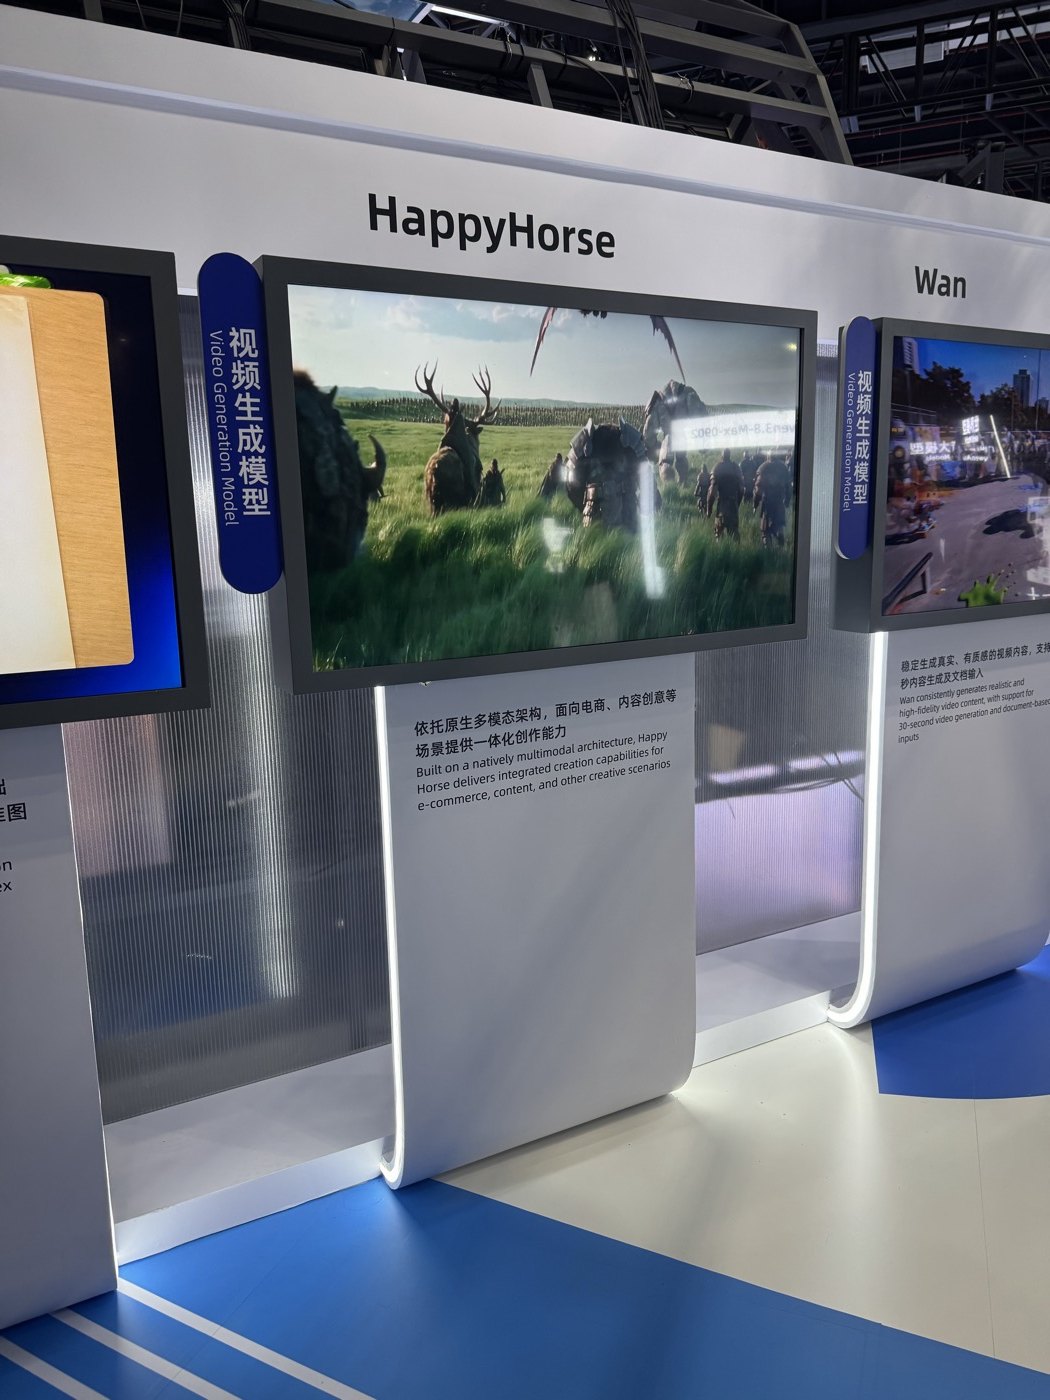
会場の別の区画には、モデルごとにモニターと白い説明板を組み合わせた立て看板が並んでいました。HappyHorse の説明板の文言は次のとおりです。
「依托原生多模态架构,面向电商、内容创意等场景提供一体化创作能力」
日本語にすると、「生まれつきマルチモーダルな構造を土台に、EC やコンテンツ制作などの場面に向けて、一体化した制作機能を提供する」という意味です。英語の併記も「Built on a natively multimodal architecture, HappyHorse delivers integrated creation capabilities for e-commerce, content, and other creative scenarios」と、ほぼ同じ内容でした。
ここで用途の筆頭に EC が挙がっていることに注目しました。大型画面のカードは映画的な映像美を押し出していましたが、立て看板では商品を売る現場が先に来ます。商品画像から短い動画を作る、同じ商品を季節や販路ごとに見せ方を変える、といった仕事は、一本あたりの単価が低く、本数が多い。人手で撮影と編集をすると割に合わない領域です。展示側がそこを狙っていると読むのは自然でしょう。
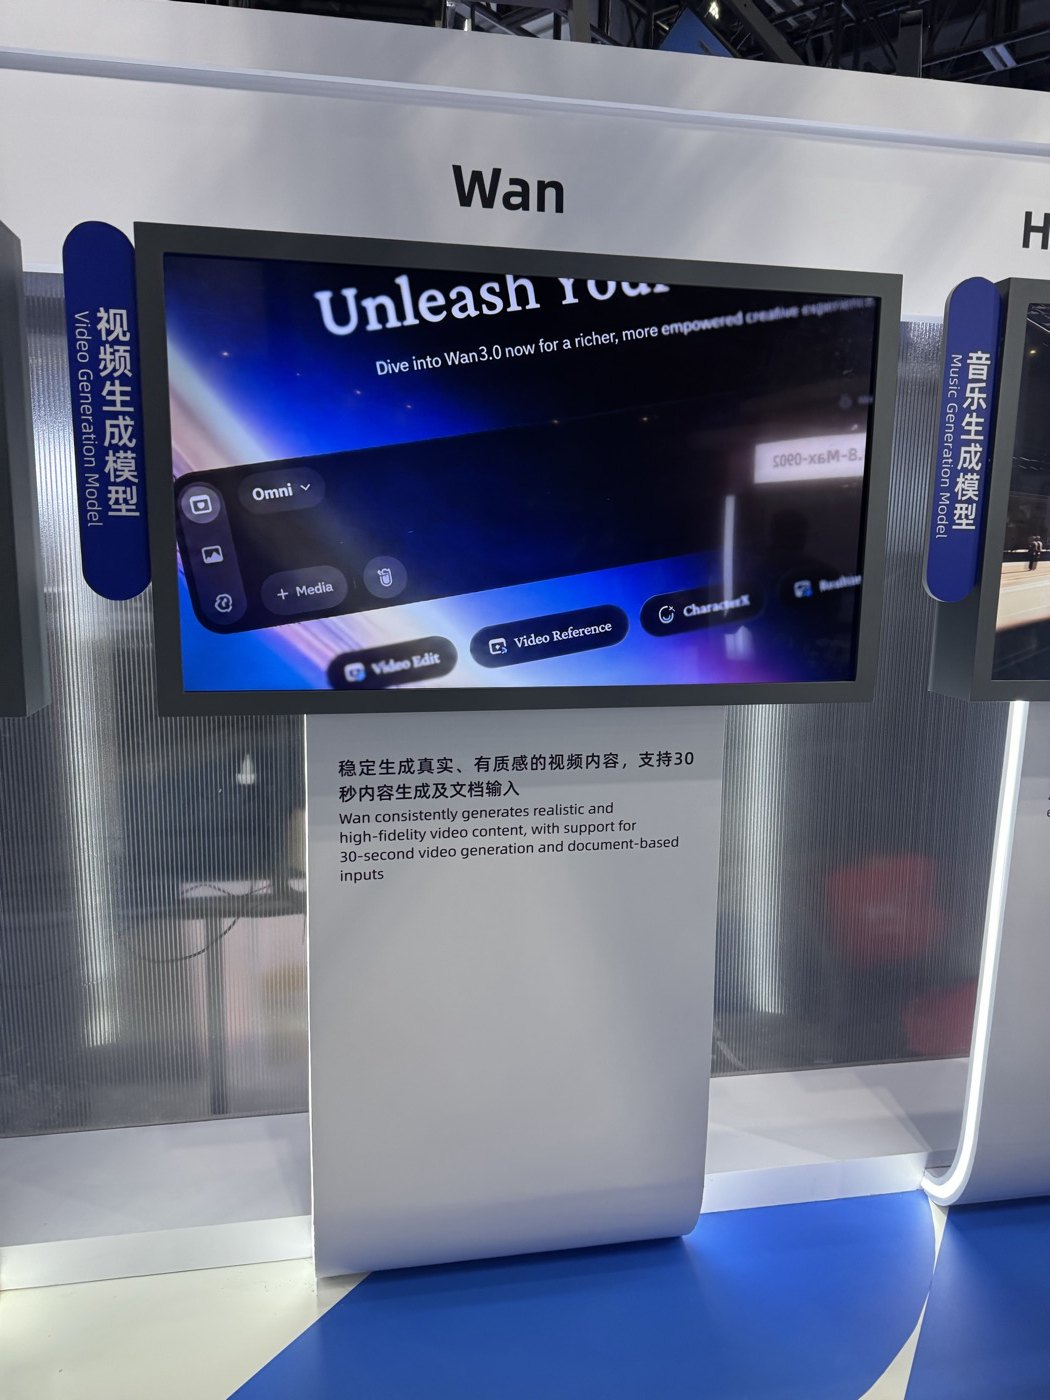
Wan の立て看板は、上に「音楽生成モデル」、下に「動画生成モデル」の札がついていました。モニターの画面は制作用アプリの入口のような作りで、「Unleash Your...」という大きな見出しの下に「Dive into Wan3.0 now for a richer, more empowered creative experience(Wan3.0 で、より豊かで力強い制作体験を)」と書かれています。画面の下には「Omni」「+ Media」「Video Edit」「Video Reference」「Character」などのボタンが並んでいました。
説明板の文言はこうです。
「稳定生成真实、有质感的视频内容,支持30秒内容生成及文档输入」
「写実的で質感のある動画を安定して生成し、30秒の生成と文書の入力に対応する」という意味で、英語の併記も「Wan consistently generates realistic and high-fidelity video content, with support for 30-second video generation and document-based inputs」でした。
「30秒」と「文書の入力」は、どちらも制作の段取りを変えうる点です。15秒前後が上限のモデルでは、30秒の広告や説明動画を作るには短い映像をつなぐ必要があります。文書を入力にできるなら、企画書や台本から直接映像を起こす使い方も考えられます。ただし、どちらも展示の説明文として記録したもので、公式の仕様書で上限や入力形式を確かめられたわけではありません。Model Studio の動画生成の案内ページ(2026年9月27日取得)には wan3.0-video と wan3.0-video-prime というモデル名が載っており、Wan 3.0 が API のモデルとして案内されていることまでは確認できました。30秒という上限と、文書入力の仕様は未確認として残します。
作例ギャラリーと、その脇の案内
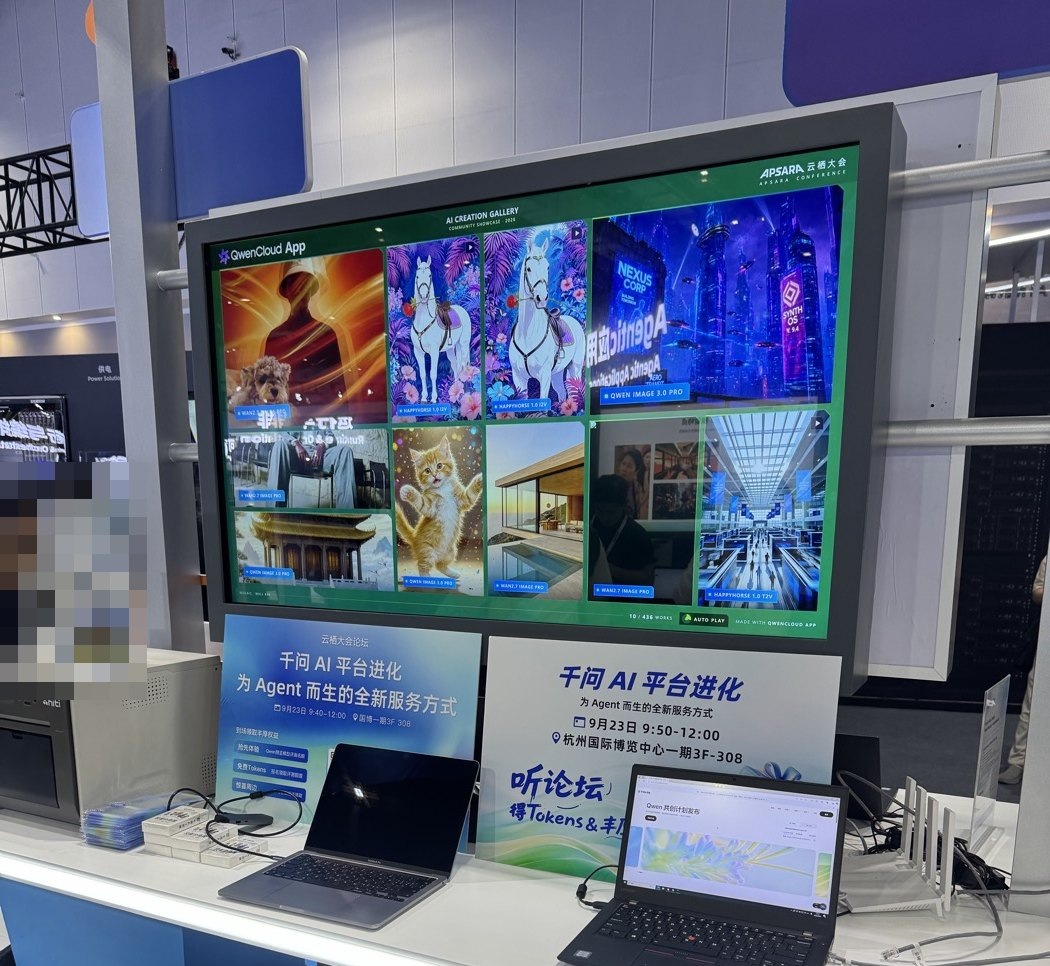
三つめの記録は、QwenCloud App の作例ギャラリーです。縦長のモニターに、キャラクターのイラスト、ネオンの街、猫の写真風の画像、料理、動物の映像など、画風の違う作例がタイル状に並んでいました。画面の上部には「AI CREATION GALLERY」の文字があります。
このタイルには生成に使ったモデル名が小さく添えられていて、過去の取材レポートでは「WAN2.7 IMAGE PRO」、別の資料では「WAN2.1 IMAGE PRO」と、版数の書き起こしが食い違っていました。タイルの文字は小さく、斜めから撮っているため、版数を読み取ることはできませんでした。本記事では版数を書かず、未解決のまま残します。
ギャラリーの下には案内板がありました。「千问 AI 平台进化 为 Agent 而生的全新服务方式」、つまり「千問 AI プラットフォームの進化、エージェントのために生まれた新しいサービスの形」と題した分科会の告知で、9月23日 9:50〜12:00、会場は国際博覧センターの3F-308とあります。その横には「听论坛 得 Tokens」、分科会を聞けばトークン(API の利用枠)がもらえる、という呼びかけも見えます。
作例を眺めてもらったあとで、API の利用枠を配って開発者を分科会に呼ぶ。ここでの作例ギャラリーは、完成品を鑑賞させる場所というより、API を使い始めてもらうための入口として置かれていました。生成モデルの競争が、見栄えの良い作例から、開発者が自社の業務に組み込めるかどうかへ移っていることが、展示の組み立てからも読み取れます。
講演スライドが示した「制作中に入れ替わるモデル」
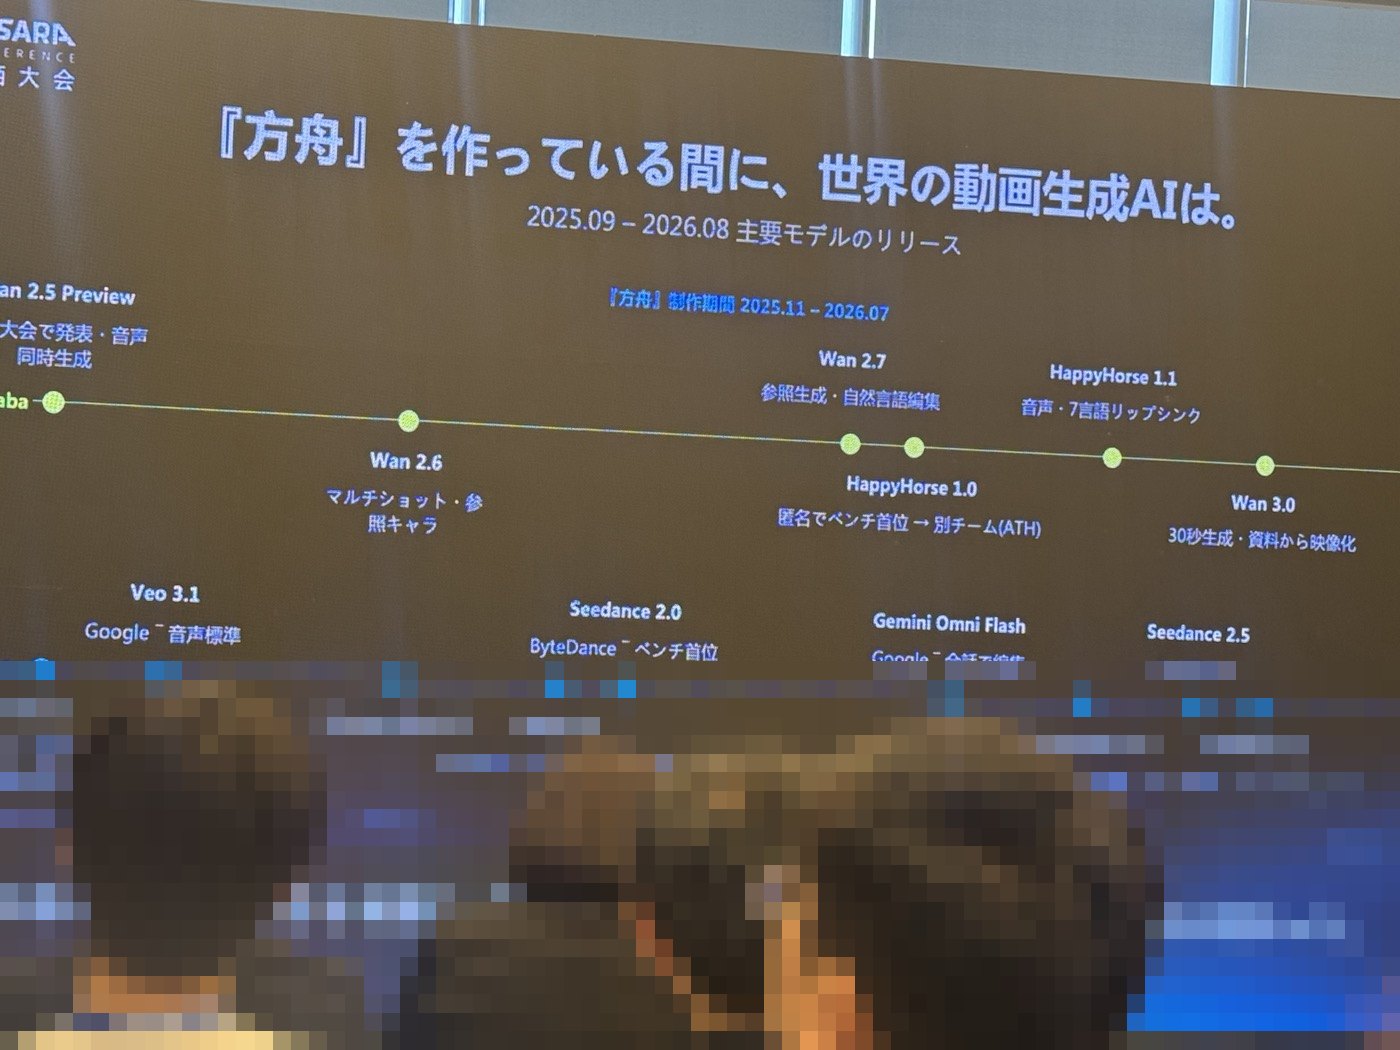
今回の記録で最も考えさせられたのは、講演会場で撮った一枚のスライドです。日本語で書かれていて、見出しは「『方舟』を作っている間に、世界の動画生成AIは。」。その下に「2025.09 – 2026.08 主要モデルのリリース」とあり、中央に「『方舟』制作期間 2025.11 – 2026.07」という帯が引かれています。
年表の上段には Alibaba 系のモデルが並んでいました。「Wan 2.5 Preview(大会で発表・音声同時生成)」「Wan 2.6(マルチショット・参照キャラ)」「Wan 2.7(参照生成・自然言語編集)」「HappyHorse 1.0(匿名でベンチ首位→別チーム(ATH))」「HappyHorse 1.1(音声・7言語リップシンク)」「Wan 3.0(30秒生成・資料から映像化)」。下段には他社のモデルが並びます。Google の Veo 3.1、OpenAI の Sora 2、Runway Gen-4.5、Kuaishou の Kling 3.0、ByteDance の Seedance 2.0 と 2.5、Google の Gemini Omni Flash、MiniMax H3 などです。スライドの最下段には「1本の……させる間に……入れ替わった」という一文が見えますが、手前の聴講者の頭に隠れて全文は読めません。
講演者の名前と、『方舟』がどんな作品なのかは記録に残っていません。したがって、ここで作品の中身や制作体制を推測することはしません。スライドから確実に言えるのは、ある映像作品の制作期間として示された約9か月のあいだに、Alibaba 系だけで五つ以上、他社を含めると十数個の主要モデルが発表されたと、講演者が整理していたことです。
生成モデルを制作業務に入れるときの、いちばん現実的な問題がここにあります。企画を立て、試作し、社内の承認を得て、本番を作るまでに数か月かかる仕事では、途中で「より良いモデル」が出てくるのが当たり前になりました。制作の途中でモデルを乗り換えれば、それまでに作った素材と画調や人物の顔がそろわなくなるおそれがあります。乗り換えなければ、完成した時点で一世代前の品質に見えるかもしれません。
年表の Alibaba 系の注記の書き方も気になりました。「参照キャラ」「参照生成」「自然言語編集」「資料から映像化」と、新しい版が出るたびに増えているのは、画質の向上そのものより「何を渡せば、何を固定できるか」という操作の種類でした。次の節では、この点を公式文書で確かめます。
公式文書で確かめる「渡せるもの」と「固定できるもの」
展示で掲げられていた特徴の句は、API 文書ではどんな指定項目になっているのでしょうか。Alibaba Cloud の生成 AI 基盤である Model Studio の API 文書を、2026年9月27日に取得して読みました。数値は取得時点のもので、今後変わる可能性があります。
動画:最初の一枚、最後の一枚、続きの映像
Wan 2.7 の画像から動画を作る API は、三つの作業を一つの入口で受け付けます。先頭のフレームから動画を作る、先頭と末尾のフレームを指定してその間を作る、そして既存の動画の続きを作る(video continuation)、の三つです。入力の種類として、先頭フレーム(first_frame)、末尾フレーム(last_frame)、動きの基準にする音声(driving_audio)、続きを作る元の映像(first_clip)を指定できると書かれています。
これは制作の段取りに直結します。最初と最後のコマを人が決められるなら、商品の置き位置やロゴの見え方を静止画の段階で承認し、そのあいだの動きだけをモデルに任せられます。動画生成の案内ページにも、「ある映像の最後のフレームを次の映像の最初のフレームにすると、つなぎ目の目立たない切り替えになり、物語や製品紹介、手順の説明に向く」という趣旨の説明がありました。
テキストから動画を作る Wan 2.7 の API では、長さは2〜15秒の整数(既定は5秒)、プロンプトは最大5,000字です。プロンプトの中で「0〜3秒は引きの画」のように時刻つきでショットを書き分ける例も載っています。
HappyHorse:参照画像を番号で呼ぶ
HappyHorse の参照から動画を作る API は、参照画像を1〜9枚まで受け付けます。プロンプトの中では、渡した順に「[Image 1]」「[Image 2]」と呼び、たとえば「[Image 1] の赤いチャイナドレスの女性」のように被写体を指定する、という例が示されていました。
テキストから動画を作る HappyHorse の API では、プロンプトの上限が「中国語以外で5,000字、中国語で2,500字」と書かれており、「Supports any language(どの言語にも対応)」とあります。処理は通常1〜5分かかる非同期の呼び出しで、要求を出してから結果を取りに行く二段階の手順です。透かしを付ける設定にすると、右下に「HappyHorse」と表示されます。提供地域の一覧には、シンガポール、米国(バージニア)、中国(北京)、ドイツ(フランクフルト)、中国(香港)に加えて、日本(東京)が載っていました。
大型画面で HappyHorse の特徴として掲げられていた「Lifelike and Emotional Characters」は、4月の公式ブログでは、口の動きに合わせた台詞、環境音、感情のこもった声の演技を含む、映像と音声を同時に出す機能として説明されています。同じブログは、複数のショットを含む最長15秒の 1080p 動画を作れるとしています。ただし、今回取得したテキストから動画の API 文書では、音声や口の動きをどの項目で指定するのかまでは読み取れませんでした。ブログの説明と API の指定項目の対応は、未確認です。
既存の映像を作り替える
Wan の特徴として掲げられていた「Free-form Video Instruction Editing」と、DesignArena の「動画から動画」部門の順位は、既存の映像を作り替える機能の話です。Wan 2.7 の動画編集の API は、指示による編集と画風の変換を受け付け、動画を1本と参照画像を渡せます。音声については、プロンプトが音を描写していれば新しい音声が作られ、そうでなければ元の素材の音声が残る場合がある、と書かれています。動画生成の案内ページでは、編集用のモデルとして happyhorse-1.0-video-edit と wan2.7-videoedit が並んでいました。
撮影済みの映像を生かして、背景の季節や画風だけを変える使い方は、ゼロから作るより品質の見通しが立てやすい方法です。人物や商品の形は元の映像が保証し、変えたい部分だけをモデルに任せられるからです。日本の現場でまず試しやすいのは、この「作り替え」のほうかもしれません。
画像:色と枠を数値で渡す
画像生成の Wan 2.7 の API には、制作の現場の感覚に近い指定項目があります。一つは色のテーマ(color_palette)で、16進の色の値と比率の組を3〜10色渡します。もう一つは枠の指定(bbox_list)で、画像の中の特定の範囲を座標で囲み、そこだけを編集の対象にします。上位版の wan2.7-image-pro は、テキストから画像を作る場合に限って4Kの出力に対応し、編集や連作は2Kまでとされています。料金の説明には、失敗した呼び出しと処理エラーには課金しない、とありました。
Qwen Image 3.0 の API は、テキストから画像を作るモードと、1〜3枚の参照画像に編集の指示を添えるモードを持っています。
ブランドの色を比率つきで渡せる、変えてよい範囲を枠で決められる。この二つは、「モデルに任せる範囲を人が決める」ための道具です。大型画面の「Controllable Multimodal Creation」という句は、こうした指定項目の積み重ねを指していると読めます。
乱数の種は保証にならない
どの API にも、乱数の種(seed)を指定する項目があります。同じ種を使えば同じ結果が出そうに思えますが、Wan 2.7 のテキストから動画の文書は、生成が確率的なため、同じ種でも同じ結果になるとは限らない、と明記しています。
制作物の再現性を種だけに頼ることはできない、ということです。採用した生成物そのものを保存し、どの入力とどの設定で作ったかを記録しておく運用が要ります。
制作の流れに組み込むときの条件
公式文書には、制作の流れを組むときに見落とすと困る条件もいくつか書かれていました。
一つめは保存期間です。Wan 2.7 のテキストから動画の API では、結果の取得に使うタスク ID が24時間有効とされ、生成物の URL も24時間で失効します。生成したら、すぐに自社の保管場所へ移す処理が要ります。
二つめは内容の審査です。Model Studio のエラーコード一覧には、入力や出力に不適切な内容が含まれる可能性があるときの「DataInspectionFailed」に加えて、「IPInfringementSuspect」、入力データに知的財産の侵害の疑いがある、というエラーが載っています。他社のキャラクターや商標に似た素材を参照に使うと、生成の途中で止まることがありえます。止まった理由をどう人に戻すか、代わりの素材をどう用意するかも、流れの設計に含める必要があります。
三つめは透かしです。Wan 2.7 のテキストから動画の API で透かしを有効にすると、右下に「AI Generated」の文字が入ります。HappyHorse は「HappyHorse」の文字です。生成物であることを示す表示をどうするかは、自社の表示方針と、配信先の規約に合わせて決めることになります。
四つめは学習データの説明です。Alibaba Cloud は Qwen と Wan の学習データの透明性についてのページを公開しており、学習データには著作権や商標、特許のある内容と、パブリックドメインの内容が含まれうること、前処理で個人情報を減らす処理をしていることを説明しています。生成物の権利と商用利用の条件そのものについては、今回の調査で契約条項の本文を取得できていません。導入の前に、利用規約と契約の条文を法務の担当者と読む必要があります。
もう一つ、自社で動かすという選択肢もあります。Wan2.2 は公式リポジトリで重みが公開されており、ライセンスは Apache 2.0 です。リポジトリの説明では、5B のモデルは24GB 以上のメモリを積んだ GPU(例として RTX 4090)で動くとされています。一方、展示にあった Wan 2.7 や Wan 3.0 の重みが公開されているかは、確認できませんでした。最新の版は API で、手元で管理したい用途は公開済みの版で、という使い分けになりそうです。
会場から読み取れる変化
ここからは筆者の見方です。
展示を順に見て感じたのは、生成モデルの売り方が「どれだけ美しい一本が出るか」から「どれだけ人の決めたとおりに作れるか」へ移りつつあることです。大型画面の特徴の句も、講演の年表の注記も、API の指定項目も、顔、文字、参照キャラクター、先頭と末尾のフレーム、色、枠と、固定できるものを増やす方向で並んでいました。
この流れが続けば、制作の仕事の分け方も変わるはずです。条件つきの予測として書くと、次のようになります。参照画像や先頭・末尾のフレームで被写体と構図を固定できる精度が、商品の形やロゴの見え方を人が承認できる水準に届けば、EC の商品動画や店頭用の短い映像は、撮影から始める仕事から、承認済みの静止画と指示から起こす仕事へ移っていくでしょう。そのとき人の仕事は、撮ることより、何を固定するかを決めること、出てきたものを検品すること、採用した素材と条件を管理することへ寄っていきます。
逆に、講演のスライドが示したように、モデルが数か月で入れ替わる状況は当面続くとみています。そうであれば、一つのモデルに合わせ込んだ手順は長持ちしません。長持ちするのは、自社の商品やブランドについて「何が守られていれば合格か」を書き出した検品の基準と、入力と出力の記録のほうです。モデルを乗り換えても、その基準で新しいモデルを評価し直せるからです。
日本企業の仕事への影響
日本の企業にとって影響が大きそうなのは、まず EC と販促です。商品数が多く、季節や販路ごとに見せ方を変える必要がある業種では、静止画から短い動画を起こす作業や、撮影済み映像の作り替えが、制作費の配分を変えうる領域です。HappyHorse の立て看板が EC を用途の筆頭に挙げていたのは、この市場を意識しているからでしょう。
社内の説明動画や手順の動画も、影響を受けやすい素材です。製品の使い方や作業手順の短い映像は、品質の要求が広告ほど高くない一方で、更新の頻度が高い素材です。先頭と末尾のフレームを指定する機能や、ある映像の最後のコマを次の映像の最初のコマにする方法は、手順を区切って作り直す用途と相性が良いと考えます。
制作会社や広告の現場では、評価の手間が増えます。モデルが数か月で入れ替わるなら、どのモデルを使うかを一度決めて終わりにはできません。同じ課題を新しいモデルで作り直して比べる評価を、定期的に回す必要があります。これを担当者の勘に任せていると、判断の根拠が残らず、社内の説明が難しくなります。
一方で、日本語の扱いは確認が必要です。HappyHorse の API 文書は「どの言語にも対応」としていますが、日本語のプロンプトでどこまで意図どおりに作れるか、画面に日本語の文字を描けるかは、今回の調査では確かめられていません。日本語の商品名やキャッチコピーを映像の中に入れる用途では、事前の試験が欠かせません。
生成モデルを制作業務に組み込むための当社の考え方
画像と動画の生成について、当社はモデルを選ぶ段階と、制作の流れに組み込む段階の両方を重視しています。
一つは、評価と選定です。企業ごとの商品やブランドの条件から、合格の基準を一緒に書き出し、候補のモデルで同じ課題を作って比べる。その基準は、新しいモデルが出たときにも評価し直せる形で残しておきます。講演のスライドが示した「制作中に入れ替わるモデル」への現実的な備えは、この基準を持っておくことだと考えています。
もう一つは、業務の流れへの接続です。生成物が24時間で消えること、審査で止まることがあること、透かしの扱いを決める必要があることなど、公式文書に書かれた条件を、自社の保管、承認、公開の手順にどうつなぐかを設計する必要があります。
そして、現場の知見の再利用です。どの参照画像を使い、どんな指示で、どの結果を採用したか。採用しなかった理由は何か。こうした記録は、担当者が替わっても次の制作に生かせる会社の資産になります。生成モデルそのものは入れ替わっていきますが、その記録と基準は残ります。
まだ確かめられていないこと
最後に、本記事で扱いきれなかった点をまとめておきます。展示の「No.1」の表示は、DesignArena と Artificial Analysis の該当ページの原文を取得できていません。Wan の説明板にあった30秒の生成と文書の入力は、公式の仕様書で上限と入力形式を確かめられていません。作例ギャラリーのタイルの版数は、写真でも読み取れませんでした。HappyHorse の音声と口の動きの生成を API のどの項目で指定するのか、生成物の権利と商用利用の条件、動画モデルの料金も未確認です。いずれも、導入を検討する段階で公式の窓口と契約の条文で確かめる必要があります。
出典
- 公式文書(2026年9月27日取得):Alibaba Cloud Model Studio「Video generation and editing」、「Wan2.7 Text-to-Video API Reference」、「Wan 2.7 image-to-video API」、「Wan 2.7 video editing API」、「HappyHorse text-to-video API reference」、「HappyHorse reference-to-video API reference」、「Wan-Image Generation and Editing 2.7 API Reference」、「Qwen Image Generation and Editing 3.0 API Reference」、「Error codes」、「Qwen & Wan Training Data Transparency and Governance」、Alibaba Cloud Blog「Alibaba Rolls Out HappyHorse 1.0 in Limited Beta」(2026年4月28日)、GitHub「Wan-Video/Wan2.2」README。
記事情報
| 取材・執筆・編集 | 株式会社Metelix |
|---|---|
| 公開日 | |
| 最終更新日 | |
| 分類 | 解説(Apsara 2026・生成AI・画像動画生成) |
| 利害関係 | 本記事は、Apsara Conference 2026の展示と公開文書をMetelixが取材・編集した技術解説です。数値は特に断りのない限りベンダー提示値であり、Metelixによる測定値ではありません。 |
| 検証方法 | 公開文書の記述は、2026年9月25日(日本時間)に公式サイト・公式ヘルプから取得し、製品名・機能名・数値などの主要な記述が公開文書に含まれることを確認しました。展示の記述は2026年9月の現地取材で確認した提示内容で、測定条件は示されていません。 |
| 評価時点 | 展示の取材は2026年9月(杭州・現地)。公開文書の閲覧日は2026年9月25日(日本時間)。内容と提供段階は閲覧時点のもので、今後変わる可能性があります。 |
関連記事
- 2026.09.26|解説AIエージェント基盤を読み解く、6つの視点:Apsara Conference 2026 技術解説シリーズ
- 2026.09.26|解説世界モデル・Physical AI編:生成と操作の違い、遅延という制約
- 2026.09.26|解説AI端末・ワークスペース編:Qwen BookからクラウドPC、ウェアラブルまで
改訂履歴
| 初版公開 | |
| 写真説明を更新 |