Apsara Conference 2026(2026年9月、杭州)の展示会場で、AIエージェントを「どこで動かし、どう待たせ、結果をどう返すか」を扱う展示をいくつか撮影した。モデルの性能や新しいアプリの派手な画面に比べると地味な題材だ。しかし、エージェントに数十分から数時間かかる仕事を任せようとすると、最初にぶつかるのはこの問題になる。
本稿では、撮影した展示パネルと看板を順にたどりながら、展示が何を伝えようとしていたかを読み解く。展示だけでは足りない部分は、Alibaba Cloud と Apache RocketMQ の公式文書(2026年9月27日に取得)で補った。そのうえで、日本企業がこの種の基盤を使うときに何が変わりそうか、筆者の見立てを書く。
最初に全体の筋を書いておく。撮影した展示から読み取れたのは、次の三つの部品の組み合わせである。
- エージェントが書いたコードは、隔離された小さな実行環境(サンドボックス)で動かし、用が済んだら休ませるか捨てる。
- 会話やタスクの記録のように残すべきデータは、サンドボックスの外の保存領域に置く。
- 時間のかかる処理の結果は、接続をつないだまま待たずに、会話ごとに用意した小さな宛先(トピック)経由で返す。
ただし、この三つを一つの製品として売っている展示があったわけではない。Function Compute、AgentRun、RocketMQ の LiteTopic、各種ストレージはそれぞれ別の製品で、担当する層も違う。三つを組み合わせる設計は筆者の読み取りであり、そのつもりで読んでほしい。
1. 入口のパネル:関数計算を「AIの実行環境」として描き直す
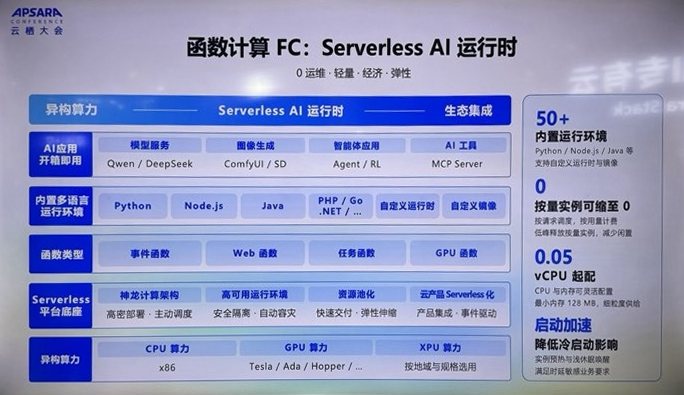
入口に置くのは、このパネルだ。タイトルは「函数计算 FC:Serverless AI 运行时」。Alibaba Cloud の関数計算サービス Function Compute(FC)を、AI向けのサーバーレス実行環境として紹介している。副題には「0运维・轻量・经济・弹性」、つまり運用の手間がない、軽い、安い、伸び縮みする、という四つの売り文句が並ぶ。
パネル本体は5段に分かれていた。上から順に見ていく。
最上段は「AI应用开箱即用」、買ってすぐ使えるAIアプリの段だ。「模型服务」(モデル提供)の下に Qwen と DeepSeek、「图像生成」(画像生成)の下に ComfyUI と SD、「智能体应用」(エージェントアプリ)の下に Agent と RL、「AI工具」(AIツール)の下に MCP Server と書かれている。モデルの推論、画像生成、エージェント、ツール接続を、どれも同じ関数計算の上で動かせる、という主張である。
2段目は内蔵の言語実行環境で、Python、Node.js、Java、PHP/Go/.NET に加え、自前の実行環境(自定义运行时)と自前のコンテナイメージ(自定义镜像)が並ぶ。3段目は関数の種類で、「事件函数」(イベントで起動する関数)、「Web 函数」、「任务函数」(タスク用の関数)、「GPU 函数」の四つ。4段目は「Serverless 平台底座」、サーバーレスの土台にあたる段で、Alibaba Cloud の仮想化基盤である神龍(神龙计算架构)による高密度配置と能動的なスケジューリング、安全な隔離と自動の障害復旧、資源のプール化による迅速な割り当てと伸縮、他のクラウド製品のサーバーレス化、という四つの箱がある。最下段は異種の計算資源で、CPU(x86)、GPU(Tesla/Ada/Hopper など)、XPU(地域と仕様に応じて選ぶ)と書かれていた。
右側の縦の列には、数字が大きく掲げられている。「50+」は内蔵の実行環境の数。「0」の下には「按量实例可缩至 0」、従量課金のインスタンスはゼロまで縮められる、とある。「0.05」は「vCPU 起配」、最小0.05 vCPUから割り当てられるという意味で、最小メモリ128MBという説明も添えられていた。いちばん下が「启动加速」(起動の高速化)と「降低冷启动影响」(コールドスタートの影響を減らす)で、小さな文字で、インスタンスを事前に温めておく仕組みと浅い休眠の仕組みに触れているように読める。ただ、写真の解像度ではこの小さな文字を一字ずつ確定できない。
このパネルは何を言おうとしていたか
筆者には、従来のサーバーレスの売り文句をエージェント向けに言い換えたパネルに見えた。
関数計算は、もともと「要求が来たときだけ短く動いて、終わったら消える」処理のための仕組みだ。画像を縮小する、通知を送る、といった数秒で終わる仕事が典型である。エージェントの仕事は性質が違う。途中で何度もコードを実行し、ツールを呼び、人の返事を待ち、長いときは数時間続く。そのあいだ、実行環境をどこまで維持し、どこで解放するかを決めなければならない。
パネルの右列で「0まで縮む」と「コールドスタートの影響を減らす」が縦に並んでいるのは、この矛盾をそのまま表している。使っていない実行環境をゼロまで減らせば費用は下がる。しかし次の要求では起動からやり直すことになり、待ち時間が延びる。この二つを両立させる工夫として、事前の準備と休眠を持ち出している、というのがパネルの筋だ。
最上段に「Agent / RL」と「MCP Server」が入っている点にも目が行く。RL は強化学習のことで、エージェントに試行錯誤をさせて学習させる用途を指すのだろう。強化学習では、使い捨ての実行環境を大量に作っては壊す。MCP Server は、エージェントが外部のツールを呼ぶための接続口を関数として置く用途だ。関数計算の用途の一覧に、こうした項目が他と同じ扱いで並んでいた。
公式文書から補うと
パネルは FC 全体の紹介だったが、エージェント専用の層として Alibaba Cloud は AgentRun という製品を公開している。公式文書によると、AgentRun は「FC を土台にしたサーバーレスの実行環境」を中核に、サンドボックス、モデルの呼び出しの管理、ツール、監視をまとめた基盤である。必要な機能だけを選んで使えることも明記されている。
実行環境については、次の記述がある。同じセッションからの要求を同じインスタンスに送る「セッション・アフィニティ」を備え、会話の続きや状態の管理を簡単にする。ゼロまでの縮小に対応し、セッションが使われなくなると資源は自動で解放され、この「浅い休眠(light sleep)」の間は課金が調整される。サンドボックスについては、少しの間アイドルになったインスタンスは浅い休眠に入り、新しい要求が来るとミリ秒単位で起きる。長く呼ばれなかったインスタンスはより省電力の深い休眠に入り、数秒で復帰できる、とされる。
ただし、浅い休眠と深い休眠のそれぞれで、メモリの中身や作業中のファイルがどこまで残るのかは、取得した文書には書かれていない。書かれているのは起きる速さだけだ。この違いは、後で扱う休眠と破棄の区別に効いてくる。
パネルの「GPU 函数」についても補っておく。FC のサーバーレスGPUの文書は、常駐のGPUと比べた違いとして、容量の事前計画がいらないこと、止まっている間は課金されないことを挙げている。推論のように負荷の波が大きい用途を想定した説明だ。
2. 区画の名前が「実行と編成」だったこと
会場のこの一角には、「运行与编排」、英語で Runtime & Orchestration と書かれた看板が掲げられていた。直訳すれば「実行と編成」である。
「編成(オーケストレーション)」は、複数の処理をどの順で、どこで、どう組み合わせて動かすかを決める仕事を指す。コンテナの世界では Kubernetes がこの役を担ってきた。エージェントの場合は、モデルの呼び出し、コードの実行、ツールの呼び出し、人の承認待ちが一つの仕事のなかで入り組むので、編成の対象はもっと細かくなる。
実行環境と編成を一つの区画にまとめたのは、展示側の整理として筋が通っている。エージェントの実行環境は、単体の性能だけでは評価できない。いつ作り、いつ止め、いつ捨てるかを誰が決めるのか、という編成の側とセットで考えないと、費用も安全性も決まらないからだ。
3. 「Agentサンドボックスの場面別体験」のコーナー
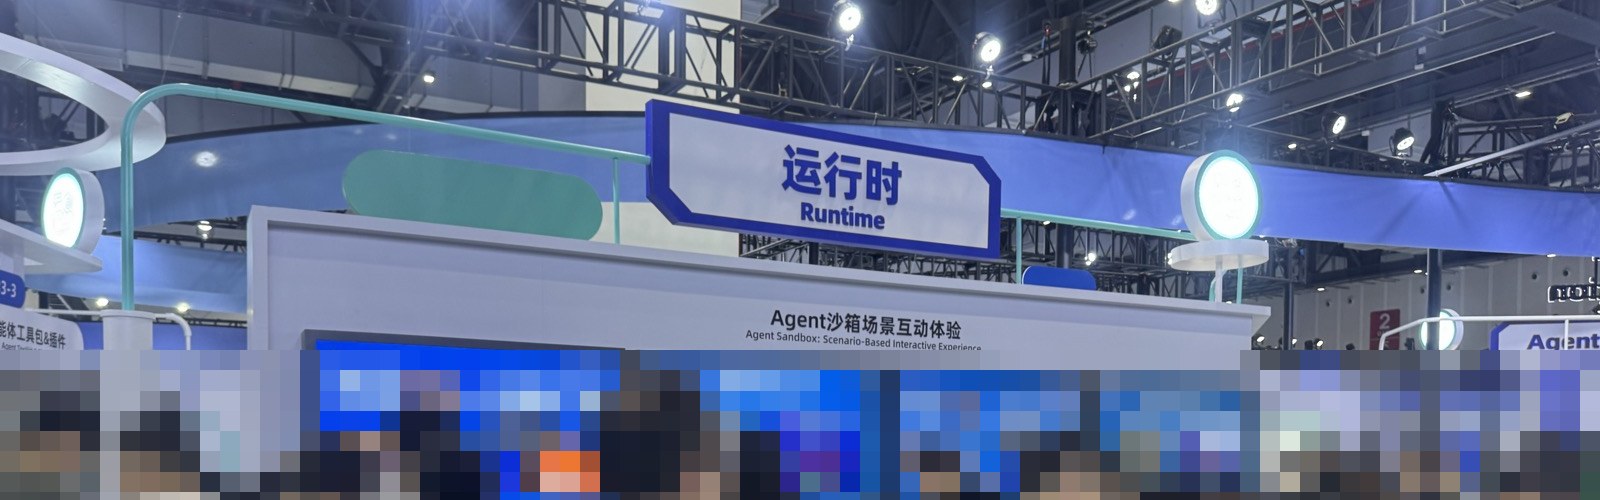
同じ区画のなかに、「运行时 Runtime」の看板を掲げたコーナーがあった。その下の表示は「Agent沙箱场景互动体验」。英語表記は Agent Sandbox: Scenario-Based Interactive Experience で、「エージェント用サンドボックスを、利用場面ごとに体験できる」コーナーという意味になる。画面の左上には「Agent Sandbox」のロゴが見える。写真の左端には、隣の区画の「Agent Toolkit & Plugins」(エージェント用のツールキットとプラグイン)の表示が一部だけ写っていた。
写真では画面に何が映っていたかを読み取れない。どの場面が用意され、どう操作する仕立てだったのかは、本稿では書かない。確かなのは、実行環境の区画のなかで、サンドボックスが「場面別に体験させる」対象として独立したコーナーを与えられていた、という事実までである。
サンドボックスとは何か、なぜ場面別なのか
サンドボックスは、プログラムを他の処理や他の利用者から切り離して動かす環境だ。エージェントが書いたコードは、人が事前に中身を確かめていない。誤ってファイルを消すかもしれないし、外部に不要な通信をするかもしれない。そこで、失敗の影響が外に広がらない小さな箱の中で動かす。
「場面別」という言い方には意味がある。エージェントがサンドボックスでやる仕事は一種類ではない。代表的なのは、コードを書いて実行する場面と、ブラウザを操作してWebページを読んだりフォームに入力したりする場面だ。AgentRun の文書を見ると、サンドボックスの種類として、コード実行用の Code Interpreter Sandbox、ブラウザ操作用の Browser Sandbox、両方を備えた AIO Sandbox の三つが挙げられている。
同じく公開されている「Sandbox Agent & Skills」(ベータ版)の文書は、このサンドボックスを MCP という標準プロトコルで外から呼ぶ手順を説明している。サンドボックスごとに MCP の接続先 URL が発行され、ブラウザ操作、ファイル操作、Office 文書の処理といった組み込みのツールを、手元のエージェントや Dify、n8n、LangChain などの編成ツールから呼べる。組み込みの機能として、Word、PDF、PowerPoint、Excel の作成や編集、ファイル検索などが並ぶ。
この文書で筆者が目を留めたのは、ベストプラクティスの欄の短い一文だ。サンドボックスは30分間操作がないと自動で停止し、この時間はテンプレート作成時に変えられる。既定の寿命(TTL)は6時間。停止した後に新しい呼び出しがあれば、自動で再起動する。つまり、このサンドボックスは最初から「放っておけば止まるもの」として設計されている。止まった後の再起動で作業中のファイルが引き継がれるのかどうかは、この文書からは読み取れない。
4. 使い捨てにする設計:休眠と破棄を分けて考える
ここからは、展示と公式文書を踏まえた筆者の整理になる。
タイトルに「サンドボックスを使い捨て」と書いた。これは、サンドボックスを長く生かしておく資産ではなく、仕事ごとに作って不要になったら手放す部品として扱う、という意味である。ただ、「手放す」には二通りある。休眠と破棄だ。この二つを混ぜると設計を誤る。
休眠は、実行環境を止めつつ中身を残すことだ。メモリの内容や作業中のファイルを保存しておき、次の要求で続きから再開する。破棄は、中身ごと消すことだ。残したいものがあれば、消す前にサンドボックスの外へ出しておかなければならない。
具体例で考えてみる。以下は筆者が設定した仮の場面である。ある社員がエージェントに「先月の売上データを集計して、部門別の報告書の下書きを作って」と頼んだとする。エージェントはサンドボックスで集計用のコードを書いて動かし、グラフを作り、途中で「部門の区分は旧組織と新組織のどちらで集計しますか」と社員に尋ねる。社員は会議中で、返事は2時間後になる。
この2時間、サンドボックスをどう扱うか。動かしたままなら、返事が来た瞬間に続きを始められるが、何もしていない計算資源の費用がかかり続ける。休眠させれば、計算資源の費用は抑えつつ、返事が来たら続きから再開できる。破棄するなら費用は最も小さいが、集計途中のデータや書きかけのコードを外に保存しておかない限り、最初からやり直しになる。
どれが正しいかは、待ち時間の長さと、やり直しの手間で決まる。数分の待ちなら動かしたままでもよい。数時間なら休眠が向く。翌日以降に持ち越すなら、必要なものを外に保存して破棄するのが筋だろう。
休眠の実例:ACS Agent Sandbox の文書
休眠を最もはっきり説明している公式文書は、今回の撮影範囲にはなかった製品のものだ。Alibaba Cloud のコンテナサービス Container Compute Service(ACS)の機能である Agent Sandbox である。取材班が撮影した展示の範囲には含まれていなかったので、ここでは公式文書の内容として紹介する。AgentRun とも FC とも別の製品で、Kubernetes の仕組みの上で動く。文書の最終更新日は2026年6月23日で、提供段階はパブリックプレビューとされている。
文書によると、ACS Agent Sandbox は MicroVM と呼ばれる軽量な仮想マシンの単位で隔離した実行環境を提供する。動作中のサンドボックスを必要に応じて休眠させ、メモリの状態を保存したまま、速く起こせる。典型的な場面では、起きてメモリの状態を戻すまでに1〜10秒かかる。メモリの状態をチェックポイントとして保存し、復元や複製もできる。あらかじめ用意した待機中の実行環境(ウォームプール)を使えば、新しいサンドボックスの作成は多くの場合数百ミリ秒で済む。大規模な場合は毎分最大15,000個のサンドボックスを作れる。GPU には対応しておらず、CPU とメモリの構成だけを選べる。
課金の記述も具体的だ。動作中は、一時ストレージの最初の30GiBは無料で、それを超えた分はクラウドディスクの価格で課金される。休眠中は vCPU とメモリの課金がかからない。ただし、一時ストレージには無料枠がなくなり、最初の30GiBを含めて使った分がすべて課金される。休眠中のネットワークなど、それ以外の課金項目の扱いは、取得した文書の範囲では確認できなかった。
この記述から読み取れるのは、休眠が「無料で置いておける状態」ではないということだ。休眠中は計算資源の代わりに、保存しているものの費用がかかる。数千のサンドボックスを休眠させたまま放置すれば、ストレージの費用が積み上がる。休眠は、再開が近いと見込めるときの選択肢であって、終わった仕事の置き場ではない。
文書は、使い道としてエージェントの強化学習とオンラインのエージェントサービスを挙げている。強化学習の場面では、大量のサンドボックスを同時に作り、速く片付け(fast teardown)、状態を使い回すことで、学習の効率を上げるとしている。ここでも作ることと片付けることが対になっている。FC の入口のパネルの最上段に「Agent / RL」が並んでいたことと、発想は同じ方向を向いている。ただし二つは別製品であり、パネルが ACS を指していたわけではない。
AgentRun の「浅い休眠」との違い
AgentRun の文書にも「浅い休眠」「深い休眠」という言葉が出てくる。しかし、ACS の休眠と同じ意味だと考えてはいけない。ACS の文書は「メモリの状態を保存する」と明記している。AgentRun の文書が明記しているのは起きる速さ(ミリ秒、または数秒)と、浅い休眠の間は課金が調整されることで、メモリが残るかどうかは、取得した範囲では書かれていない。
製品が違えば、同じ「休眠」という言葉でも保証の中身が違う。設計のときは、言葉ではなく「何が残り、何が消え、何に課金されるか」を製品ごとに確かめる必要がある。
5. 残すデータの置き場:会場のストレージ展示
サンドボックスを使い捨てにするなら、残すべきデータを置く場所が要る。会場では、ストレージの区画でもエージェント向けの展示が三つあった。本稿の主題はそこではないので、実行基盤とのつながりに絞って紹介する。
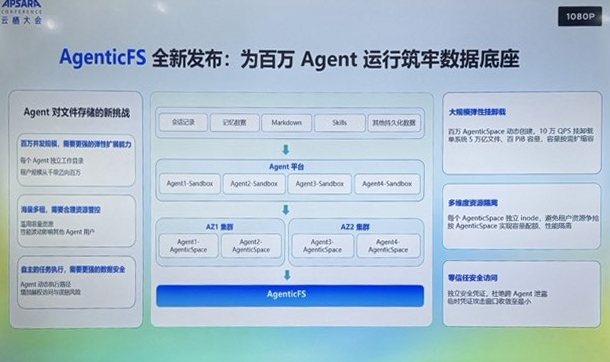
一つ目は AgenticFS だ。タイトルは「AgenticFS 全新发布:为百万 Agent 运行筑牢数据底座」、新しく出した AgenticFS で、百万単位のエージェントの実行を支えるデータの土台を築く、という意味になる。中央の図がわかりやすい。上に「会话记录」(会話記録)、「记忆数据」(記憶データ)、Markdown、Skills、「其他持久化数据」(その他の永続データ)が並ぶ。その下に Agent1-Sandbox から Agent4-Sandbox までの四つのサンドボックス、さらにその下に二つのゾーン(AZ1、AZ2)の集合として、エージェントごとの AgenticSpace が描かれ、最下段が AgenticFS になっている。
この図は、本稿の設計論にそのまま重なる。サンドボックスは入れ替わっても、会話の記録や記憶はエージェントごとの領域に残る、という絵だ。
公式文書を見ると、AgenticFS はファイルストレージ NAS の一種で、エージェント向けのサーバーレスなファイルストレージとされる。一つのファイルシステムで最大50万の AgenticSpace を管理でき、AgenticSpace はエージェントの利用者一人ひとりに割り当てる独立した作業領域として、容量の上限、アクセスの分離、性能の分離を提供する。同じ利用者の複数のセッションは、その利用者の AgenticSpace の下のサブディレクトリに対応づけられ、会話ログ、記憶、Markdown ファイル、Skills などの永続データを置く、と書かれている。パネルの図と同じ内容だ。
パネルの見出しは「百万 Agent」、文書の上限は1ファイルシステムあたり50万 AgenticSpace で、数字の単位がそろっていない。パネルの数字が複数のファイルシステムをまとめた規模を指すのかどうかは、確認できなかった。文書では、提供段階は招待制のプレビューである。対応リージョンの一覧は中国本土の4リージョン、シンガポール、マレーシア(ジョホール)、米国(バージニア)で、取得時点では日本のリージョンは載っていなかった。
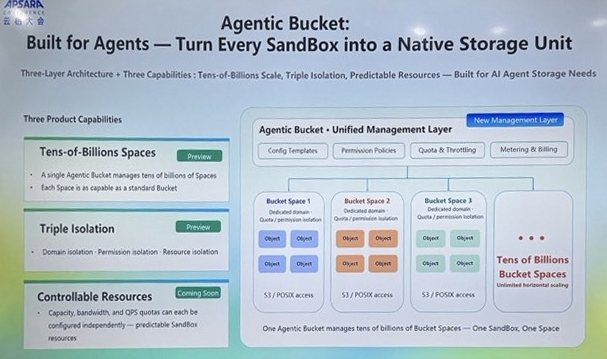
二つ目は Agentic Bucket のパネルで、英語で書かれていた。副題は「Turn Every SandBox into a Native Storage Unit」、すべてのサンドボックスを一つの保存単位にする、という意味だ。図の下には「One Agentic Bucket manages tens of billions of Bucket Spaces — One SandBox, One Space」とあり、一つの Agentic Bucket で数百億の Bucket Space を管理し、サンドボックス一つに領域一つを割り当てる、という考え方を示している。
左側の3つの機能には、それぞれ提供段階が書き添えられていた。数百億の領域(Tens-of-Billions Spaces)と三重の分離(Triple Isolation。ドメイン、権限、資源の分離)は Preview、容量・帯域・QPS の上限を個別に設定できる資源管理(Controllable Resources)は Coming Soon である。右側の図では、「Unified Management Layer」(統合管理層)に設定テンプレート、権限ポリシー、上限と流量制御、計量と課金が並び、その下の各 Bucket Space に専用のドメインと S3/POSIX でのアクセスが描かれている。この製品の公式文書は今回取得できていないため、ここではパネルに書かれていたことだけを紹介する。
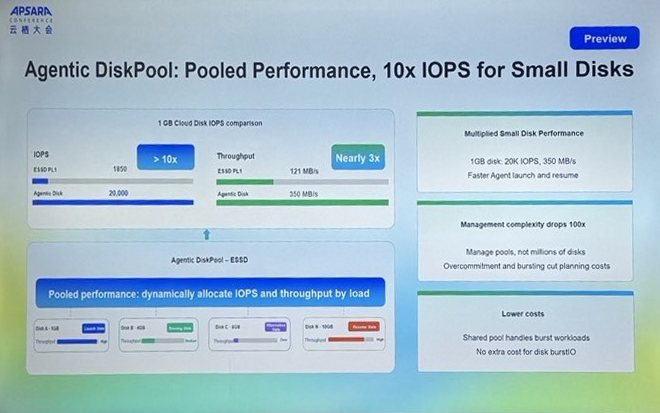
三つ目は Agentic DiskPool で、これも英語のパネルだった。右上に Preview とある。1GBのクラウドディスクで比べると、IOPS は ESSD PL1 の1,850に対して Agentic Disk は20,000(「> 10x」)、スループットは121MB/s に対して350MB/s(「Nearly 3x」)という比較が示されていた。下の図は、容量の異なる複数のディスクが一つのプールの性能を負荷に応じて分け合う仕組みを描いている。各ディスクには起動中や実行中などの状態を示すラベルが付いているが、写真では一部の文字を読み切れない。右側には「Faster Agent launch and resume」(エージェントの起動と再開を速く)、「Manage pools, not millions of disks」(何百万のディスクではなくプールを管理する)、「No extra cost for disk burst IO」(ディスクの一時的な高負荷に追加費用なし)といった説明が並ぶ。
これらの数字はいずれも展示側の比較で、測定条件はパネルに書かれていない。DiskPool の図にあるディスクの状態は、ディスクの性能をどう配るかの話であって、先に紹介した ACS のサンドボックスの休眠とは別の製品の別の仕組みである。同じ「再開」という言葉が出てきても、一つにまとめて考えないほうがよい。
三つの展示に共通しているのは、エージェントやサンドボックスを「一つずつ独立した単位」として数え、その数が膨大になる前提で設計している点だ。ファイルシステムなら50万、バケットなら数百億の領域、ディスクなら何百万台。従来のストレージが「一つの大きな領域を多くの人で共有する」形だったのに対し、ここでは「小さな領域を大量に配る」形が前面に出ている。サンドボックスを使い捨てにする設計と、表裏の関係にある。
6. 結果をどう返すか:LiteTopic のパネル
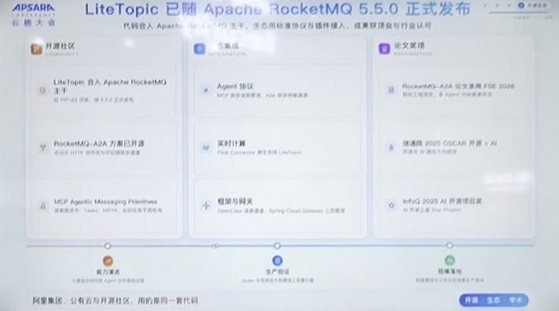
実行環境と保存領域の次は、結果の受け渡しだ。会場には、メッセージキューの Apache RocketMQ についてのパネルがあった。タイトルは「LiteTopic 已随 Apache RocketMQ 5.5.0 正式发布」、LiteTopic が Apache RocketMQ 5.5.0 とともに正式に公開された、という意味である。
パネルは3列で構成されていた。左の列は「开源社区」(オープンソースコミュニティ)で、LiteTopic が Apache RocketMQ の本流のコードに取り込まれたこと、「RocketMQ-A2A 方案已开源」(RocketMQ で A2A を実現する方式をオープンソースにした)こと、「MCP Agentic Messaging Primitives」という提案が並ぶ。中央の列はエコシステムとの連携で、エージェント向けのプロトコル、リアルタイム計算、フレームワークとゲートウェイの項目がある。右の列は論文と受賞で、RocketMQ-A2A の論文が FSE 2026 に採択されたことなどが挙げられていた。いちばん下には「阿里集团、公有云与开源社区,用的是同一套代码」、アリババグループ、パブリッククラウド、オープンソースコミュニティが同じコードを使っている、という一文がある。これは展示側の主張で、本稿では確かめていない。細かい説明文の多くは、写真の解像度では読み切れなかった。
LiteTopic とは何か
メッセージキューは、送り手と受け手の間でメッセージを預かり、順に届ける仕組みだ。トピックは、その中で「どの種類のメッセージを、どこへ届けるか」を分ける名前付きの宛先である。
従来のトピックは、あらかじめ作っておく比較的重い資源だった。注文の通知用、在庫の更新用といった具合に、業務の種類ごとに数個から数十個を用意するのが普通の使い方だ。会話一つごとにトピックを作るのは現実的ではなかった。
Apache RocketMQ の公式文書は、LiteTopic を「一つの親トピックの中に作る、軽量で一時的な下位の経路」と説明している。セッション、タスク、利用者ごとに一つずつ、数百万の細かい経路を、別々のトピックを作る負担なしに作れる。要点を拾うと次のとおりだ。
- 初めて使うときに自動で作られる。メッセージに LiteTopic の名前を指定して送り、それが存在しなければシステムが作る。
- 設定した期間(TTL)を超えてメッセージが来なければ、自動で削除される。
- 各 LiteTopic は既定でキューを一つだけ持ち、メッセージは順番どおりに保存され、順番どおりに消費される。
- 同じ消費者グループのなかで、消費者ごとに違う LiteTopic の組を購読できる。購読は動作中に追加・削除でき、1つの消費者は数千の LiteTopic を購読できる。
- 使うにはサーバー側が 5.5.0 以降、クライアントは gRPC SDK の 5.1.0 以降が必要。
文書は、制約もはっきり書いている。キューが一つなので、経路ごとの処理量(TPS)には上限がある。全体の処理量は LiteTopic の数に応じて伸びる。監視の面では、滞留しているメッセージの数は見られるが、処理の遅延の指標は提供されていない。文書は、この得失を評価してから採用するよう促している。
設計の背景は、RocketMQ の改善提案 RIP-83 に書かれている。提案の状態は「Shipped」(出荷済み)だ。動機の説明では、AI ゲートウェイが要求を複数の AI サービスに振り分け、各サービスが非同期に処理した結果を、要求を受けた特定のゲートウェイのインスタンスへ返す必要がある、という場面が挙げられている。エージェント同士の通信でも、全員に配るのではなく特定の相手に届けたい。従来の配信と購読(pub/sub)は送り手と受け手を切り離すのは得意だが、特定の宛先に確実に届ける保証がない。LiteTopic はこの穴を埋めるための仕組みだと説明されている。
公開の時期も確かめた。Apache のアーカイブでは、RocketMQ 5.5.0 の配布物の日付は2026年4月16日になっている。遅くともこの時点で配布物が公開されていたことになり、大会の約5か月前だ。会場のパネルは新発表というより、すでに出たものを AI 向けの文脈で改めて紹介するものだったと言える。
会話ごとにトピックを作ると何がうれしいか
先ほどの売上集計の例に戻る。エージェントの処理に2時間かかるとき、依頼した画面やアプリが接続をつないだまま待つのは無理がある。途中でネットワークが切れるかもしれないし、中継する機器のタイムアウトに引っかかるかもしれない。
そこで、会話ごとに LiteTopic を一つ割り当てる。エージェントは途中経過や最終結果をその LiteTopic に送る。依頼した側は、つながったときにその LiteTopic から順にメッセージを受け取る。会話が終わってしばらく何も来なければ、LiteTopic は TTL で自動的に消える。
この形の利点は、実行環境と通信の寿命を切り離せることだ。サンドボックスが休眠しても破棄されても、結果を返す経路は別にある。逆に、受け取る側が一時的に落ちていても、メッセージはキューに残る。LiteTopic は一つの経路の中で順番を保つので、「途中経過1、途中経過2、完了」という順序が崩れにくい。
注意点もある。キューが一つなので、一つの会話に大量のメッセージを流す使い方には向かない。遅延の指標がないので、「この会話の返事がなぜ遅いのか」を LiteTopic だけで調べるのは難しく、別の監視の仕組みと組み合わせる必要がある。失敗したメッセージの再試行と、最後まで処理できなかったメッセージを隔離するデッドレターキューは、RocketMQ 一般の文書に説明がある。ただし、LiteTopic に固有の挙動として確かめたわけではない。
MCP との関係
パネルの左の列にあった「MCP Agentic Messaging Primitives」にも触れておく。MCP は、エージェントが外部のツールやデータにつながるための標準プロトコルである。パネルでは提案の一つとして挙げられていたが、取得した MCP の公式文書の範囲では、この名前の仕組みは見当たらなかった。提案段階のものと考えるのが妥当だろう。
一方、MCP の公式サイトには、時間のかかるツール呼び出しを扱う Tasks という拡張の説明がある。ツールが処理に時間のかかる場合、サーバーはすぐに結果を返す代わりに、後から参照できる識別子(durable handle)を返す。クライアントはその識別子で進み具合を問い合わせ、必要なら途中で入力を渡し、接続し直した後でも最終結果を受け取れる。状態は「作業中」「入力待ち」「完了」「失敗」「取り消し」で表される。文書は、接続をつないだまま待つやり方の問題として、中継機器のタイムアウトやクライアントの再起動を挙げている。
MCP の Tasks は、プロトコルの層で「長い処理を待たずに後で受け取る」ための約束を決めるものだ。LiteTopic は、メッセージ基盤の層で「会話ごとの宛先に順に届ける」仕組みを提供するものだ。両者は層が違い、どちらかがどちらかの実装だという関係は、取得した資料からは読み取れない。ただ、長い処理を待たずに受け取るという同じ問題に、別々の層から手が付けられているのは確かだ。
7. 三つの層を並べてみる
ここまでの展示と文書を、層ごとに並べ直す。会場にこの整理図があったわけではない。
一つ目の層は実行だ。エージェントの書いたコードを隔離して動かす。会場では FC の Serverless AI Runtime のパネルと、サンドボックスの体験コーナーがこの層を扱っていた。公式文書では AgentRun のサンドボックスと、撮影範囲外の ACS Agent Sandbox がある。
二つ目の層は保存だ。サンドボックスが消えても残すべき会話記録、記憶、成果物を置く。会場では AgenticFS、Agentic Bucket、Agentic DiskPool がこの層を扱っていた。
三つ目の層は受け渡しだ。時間のかかる処理の結果を、接続を保たずに届ける。会場では RocketMQ の LiteTopic がこの層を扱い、プロトコルの側では MCP の Tasks 拡張が同じ問題を扱っている。
この三層を分けて考えると、サンドボックスをためらわずに使い捨てられるようになる。残すべきものは保存の層に、伝えるべきものは受け渡しの層に逃がしてあるからだ。逆に、保存と受け渡しを実行環境の中に抱え込んだままだと、サンドボックスを止めることも捨てることも怖くなり、結局は動かしっぱなしになる。費用は膨らみ、隔離の意味も薄れる。
8. 筆者の見立て:これから何が起きそうか
ここからは予測である。根拠は上に書いた展示と文書に限られる。
一つ目。エージェントの実行環境が「仕事一つにつき一つ」になっていくなら、実行環境の数は利用者の数ではなく仕事の数で決まるようになるだろう。一人の社員が並行して五つの仕事を任せれば、五つのサンドボックスが同時に動く。そうなれば、サンドボックスの料金は一つあたりの単価より、休眠や破棄のルールで総額が決まるようになるはずだ。ACS の文書が休眠中のストレージ課金を細かく書いているのは、利用者がすでにこの点を気にし始めていることの表れだと思う。
二つ目。会話ごとに宛先を作る方式が広がるなら、「このエージェントの返事はどこに届いたのか」を追跡する仕事が増えるだろう。LiteTopic は滞留の数は見せるが、遅延の指標を持たない。会話の数だけ宛先がある世界では、監視の設計を最初から考えておかないと、トラブルの原因を探せなくなる。
三つ目。ストレージの展示がそろって「エージェントごとの領域」を打ち出していたことから、エージェントの記憶や作業記録を利用者ごとに分けて保管する設計は、今後の標準的な前提になると筆者は見ている。そうなれば、その領域の中身を誰が見られるか、いつ消すか、という管理の問題が、ファイルサーバーの権限管理と同じくらい普通の業務になるはずだ。
四つ目は注意点だ。今回見た製品の多くは、プレビューやベータの段階にある。ACS Agent Sandbox はパブリックプレビュー、AgenticFS は招待制のプレビュー、Sandbox Agent & Skills はベータ、Agentic Bucket と DiskPool はパネル上で Preview または Coming Soon だった。数値や仕様は、正式提供までに変わる可能性がある。本番の業務に組み込むなら、提供段階と対応リージョンを確かめてから判断することになる。
9. 日本企業の仕事にどう効いてくるか
この話は、クラウドの担当者だけの問題ではない。エージェントに仕事を任せる業務部門の働き方にも関わってくる。
まず、「待つ」ことが設計に入ってくる。これまでの業務システムでは、ボタンを押したら数秒で結果が出るのが当たり前だった。エージェントに任せる仕事は、途中で人に確認を求め、返事を待ち、数時間後に結果を返す。日本企業の業務は承認や確認の段階が多い。稟議、上長の確認、他部署への照会といった手順だ。エージェントがこうした手順の途中で止まって待つ時間は、思ったより長くなるだろう。その待ち時間にサンドボックスを休眠させるのか、状態を外に保存して破棄するのかは、技術の選択であると同時に、業務の流れをどう切るかという選択でもある。
次に、データの置き場所を先に決める必要が出てくる。エージェントの会話記録や作業途中のファイルを、どのリージョンの、どの保存領域に置くのか。今回確認した AgenticFS の対応リージョンに日本は入っていなかった。個人情報や社外秘の資料を扱う業務では、データを国内に置くことが条件になる場合が多い。展示で見た仕組みの考え方は参考になるが、そのまま使えるかどうかは、リージョンと契約の条件を確かめないと決められない。
三つ目は、捨てる手順を決めることだ。サンドボックスを使い捨てにする設計では、捨てる前に何を残すかの手順が欠かせない。どの成果物を保存し、どのログを監査用に残し、何を消すのか。これは技術の設定だけでは決まらない。業務ごとに、残すべき記録の範囲を決める必要がある。日本企業では、文書の保存期間や監査対応のルールがすでに社内にあることが多い。エージェントの作業記録を、そのルールのどこに位置づけるかを考える仕事が生まれる。
四つ目は、結果の受け取り方の変化だ。エージェントの結果が非同期で返ってくるなら、社員は依頼した画面の前で待つ必要がない。代わりに、結果がどこに、どの順番で届くのかを知っている必要がある。チャットに通知が来るのか、業務システムの画面に反映されるのか。途中経過をどこまで見せるのか。これは利用者の体験の設計であり、業務部門と情報システム部門が一緒に決めるべきことだ。
10. 実行基盤の選定と運用で当社が重視すること
最後に、この展示を踏まえた当社の考え方を記しておく。当社は、海外の技術と日本企業の業務をつなぎ、AIに仕事を任せられる状態をつくることを目指している。
一つ目は、評価と選定だ。今回見たように、同じ「サンドボックス」「休眠」という言葉でも、製品によって残るものや課金の対象が違う。提供段階や対応リージョンもまちまちである。パネルの売り文句ではなく、何が残り、何が消え、何にいくらかかるかという観点で候補を比べ、企業の業務条件に合うかを確かめることが、選定の出発点になる。
二つ目は、業務との接続だ。エージェントがどこで止まり、誰の返事を待ち、その間の状態をどう扱うのか。これは業務の流れを知らなければ決められない。当社は、承認や確認の多い日本企業の業務の流れを、休眠・破棄・保存・通知という設計の言葉に置き換える作業を重視している。
三つ目は、現場で得た知見を再利用できる形にすることだ。どの業務でどれくらいの待ち時間が生じ、どの設定で費用がどう変わったか。導入のたびに得られるこうした知見を、次の導入で使える形に整理していくことを目指している。展示にあったのは基盤の部品で、仕事に使える形に組み立てるには現場の条件を知っている必要がある。当社が担おうとしているのは、この組み立ての部分である。
出典
- 展示写真:取材班撮影(Apsara Conference 2026、杭州)。展示文言は写真から読み取った範囲のみ記載。
- src01 AgentRun 概要(Alibaba Cloud):https://help.aliyun.com/en/functioncompute/what-is-agentrun
- src02 Sandbox Agent & Skills(ベータ、Alibaba Cloud):https://help.aliyun.com/en/functioncompute/using-sandbox-agent-skills-in-beta
- src03 ACS Agent Sandbox(Alibaba Cloud):https://www.alibabacloud.com/help/en/cs/user-guide/agent-sandbox/
- src04 LiteTopic(Apache RocketMQ):https://rocketmq.apache.org/docs/domainModel/03litetopic/
- src05 RIP-83 Lite Topic(Apache RocketMQ Wiki):https://github.com/apache/rocketmq/wiki/RIP%E2%80%9083-Lite-Topic:-A-New-Message-Model
- src06 RocketMQ 5.5.0 配布アーカイブ(Apache):https://archive.apache.org/dist/rocketmq/5.5.0/
- src07 AgenticFS 概要(Alibaba Cloud):https://www.alibabacloud.com/help/en/nas/product-overview/agenticfs-overview
- src08 RocketMQ 消費の再試行(Apache RocketMQ):https://rocketmq.apache.org/docs/featureBehavior/10consumerretrypolicy/
- src09 FC サーバーレスGPU(Alibaba Cloud):https://www.alibabacloud.com/help/en/functioncompute/fc/user-guide/introduction-to-serverless-gpus-1
- src10 MCP Tasks 拡張(Model Context Protocol):https://modelcontextprotocol.io/extensions/tasks/overview
- いずれも2026年9月27日(UTC)に取得。
記事情報
| 取材・執筆・編集 | 株式会社Metelix |
|---|---|
| 公開日 | |
| 最終更新日 | |
| 分類 | 解説(エージェント実行基盤・サンドボックス隔離・非同期メッセージング) |
| 利害関係 | 本記事は、Apsara Conference 2026の展示と公開文書をMetelixが取材・編集した技術解説です。数値は特に断りのない限りベンダー提示値であり、Metelixによる測定値ではありません。 |
| 検証方法 | 公開文書の記述は、2026年9月26日(日本時間)に公式サイト・公式リポジトリから一次情報を取得し、本文に含まれる文字列と一致することを確認しました。展示の記述は2026年9月の現地取材で確認した提示内容で、測定条件は示されていません。 |
| 評価時点 | 展示の取材は2026年9月(杭州・現地)。公開文書の初回閲覧日は2026年9月25日(日本時間)、再確認日は2026年9月26日(日本時間)。内容と提供段階は閲覧時点のもので、今後変わる可能性があります。 |
関連記事
- 2026.09.26|解説AIエージェント基盤を読み解く、6つの視点:Apsara Conference 2026 技術解説シリーズ
- 2026.09.26|解説世界モデル・Physical AI編:生成と操作の違い、遅延という制約
- 2026.09.26|解説AI端末・ワークスペース編:Qwen BookからクラウドPC、ウェアラブルまで
改訂履歴
| 初版公開 | |
| 写真説明を更新 |