

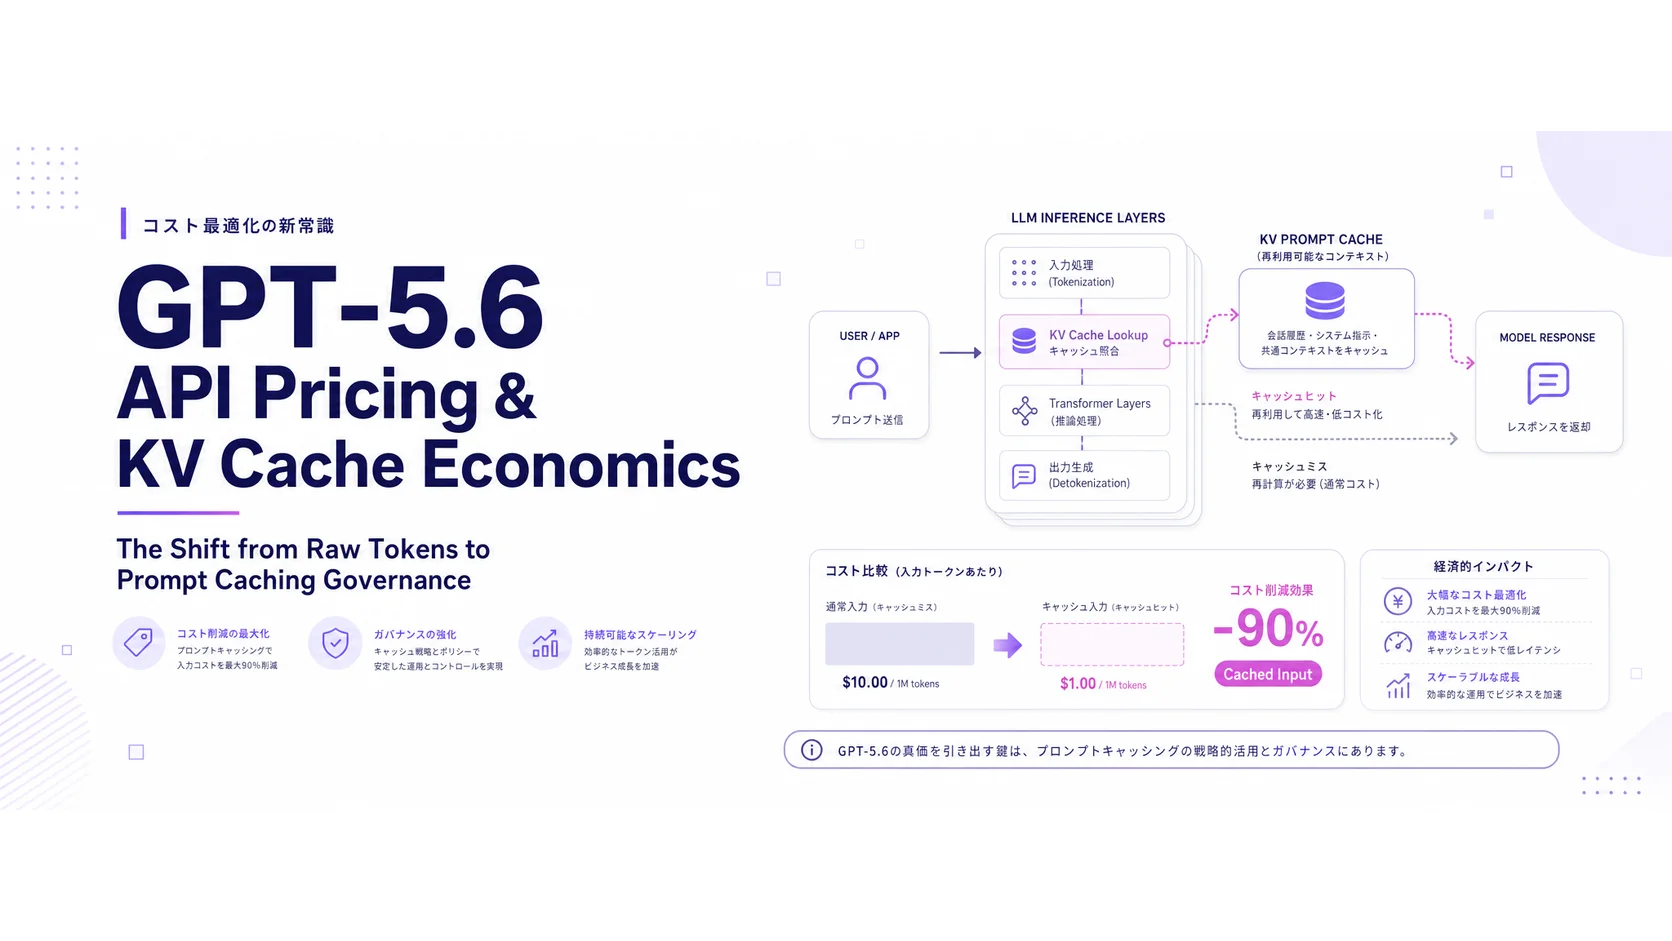
GPT-5.6 Lunaの登場が、Agenticワークロードの経済設計を根本から問い直している。 Solが最高品質の代名詞として存在し、Terraがバランス型として定着しつつある中、Lunaは「業界最安水準のInput単価」という新しい基準軸を持ち込みました。価格表の数字だけを比べても不十分です。どのモデルをどの経路で呼ぶか。ルーティング設計そのものが競争優位になる段階に入っています。
本稿は2026年8月25日時点の公式情報を根拠に、GPT-5.6世代(Sol/Terra/Luna)・Claude Sonnet 5の4モデルを定性的に比較し、業務タスク別のルーティング方針と割引経路の使い分けを整理します。精度ベンチマーク(MMLU等)の未確認数値は創作せず、不確かな項目は明示します。DeepSeek V4-Pro(Tencent TokenHub経由)は、TokenHub固有の料金・処理モード・データ保持条件の一次情報が確認できていないため、実測ベンチマーク記事で別途検証予定です。
研究要旨(要約、直接引用ではありません)
"Don't Break the Cache" は、500超のエージェントセッションを対象にOpenAI・Anthropic・Googleのプロンプトキャッシュを比較し、APIコストを41〜80%、Time to First Token(TTFT)を13〜31%改善したと報告しています。一方、動的なツール結果を無造作に含めるフルコンテキストキャッシュは、かえってレイテンシを悪化させる場合があり、変動部分を後方へ置くなどのキャッシュ境界設計が重要だと示しています。
※arXiv:2601.06007のAbstractを、引用ではなく要約したものです。
出典 arXiv:2601.06007(研究内容の参照先)。
1. GPT-5.6 Lunaが変えたこと:価格改定は「モデル単価表」ではない
APIの請求は、入力と出力の量だけで決まりません。共通プレフィックスがプロバイダーの条件を満たして再利用されたか、即時実行を要求したか、非同期の一括処理に回せたかで、同じ業務でも請求額が変わります。Lunaのような低単価モデルが登場したことで、「品質が必要なタスクは高性能モデル、定型・大量処理はLuna」という分岐設計が現実的な選択肢になりました。
| 費目 | 見るべき条件 | 運用上の意味 |
|---|---|---|
| 通常入力 | 新規に計算するトークン | プロンプト設計・検索結果・ツール出力の増分が効く |
| Cached Input | 共通プレフィックスとキャッシュ条件の充足 | ヒット率を実測しなければ予算には使えない |
| 出力 | 生成長・思考過程を含む提供仕様 | 入力割引だけでは抑えられない。上限設計が要る |
| Flex / Batch | 遅延許容、各サービスの受付・完了条件 | 緊急性の低い仕事を即時経路から外す選択肢 |
GPT-5.6の標準価格:LunaのInput単価は業界最安水準
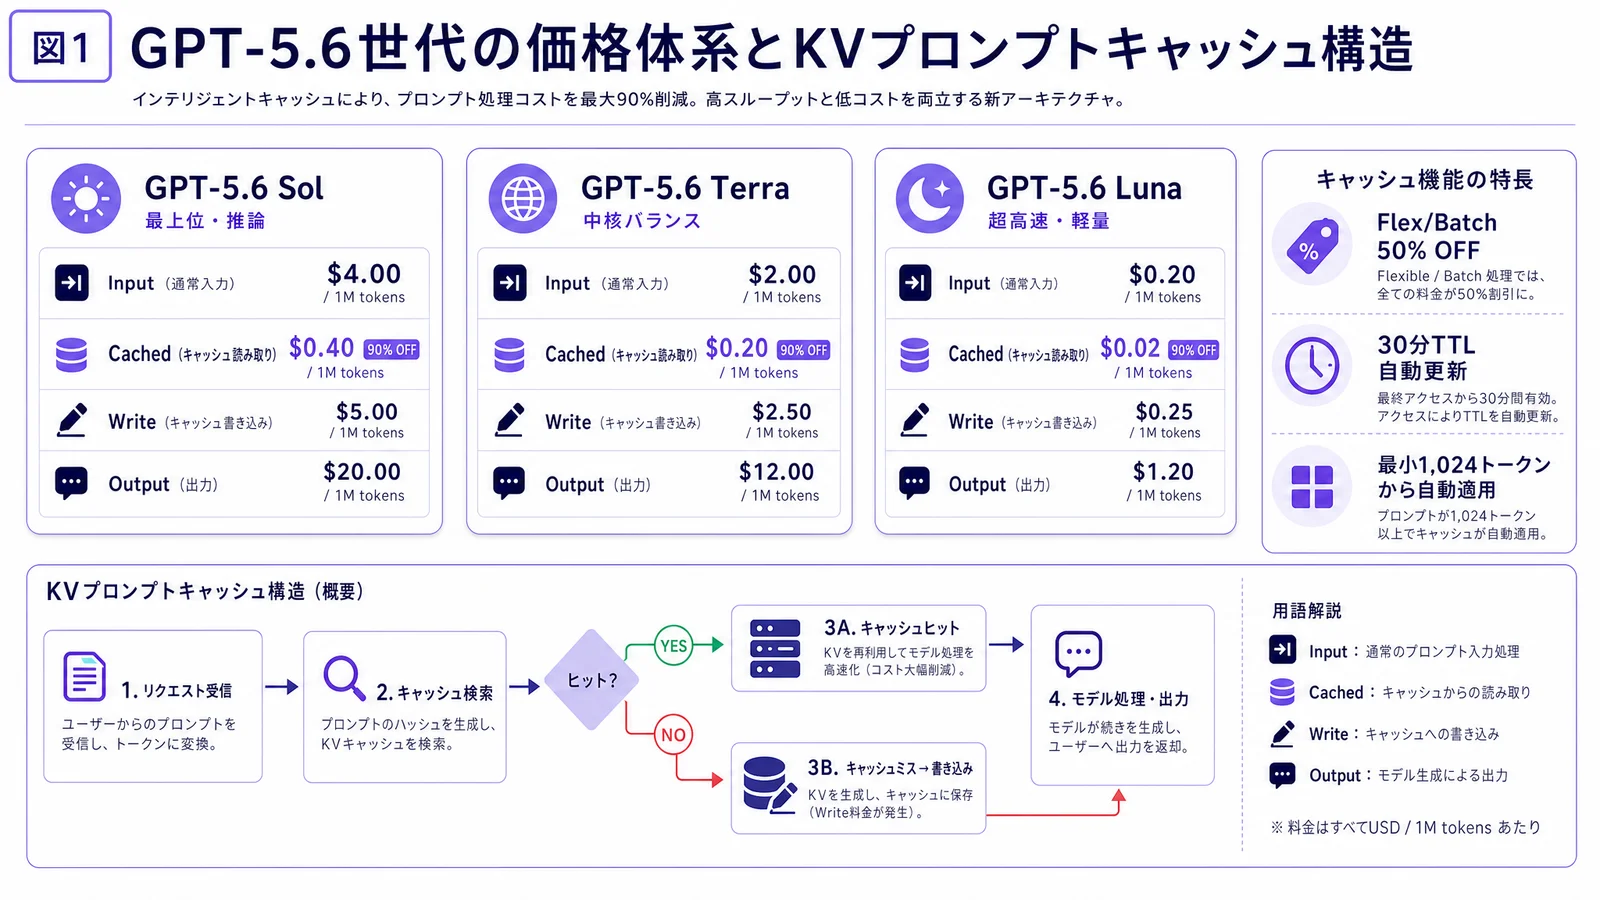
OpenAIの公式料金ページが2026年8月25日時点で示す短文脈・Standardモードの価格は、次のとおりです(USD / 100万トークン)。Lunaの通常入力$0.20、Cached Input $0.02は、主要プロバイダーの主力モデルとして公式に提示されている価格の中で最低水準です。FlexとBatchでは各費目がStandardの50%となり、待ち時間を許容できる処理にはもう一段の削減余地があります。なお、Solの表示価格は少なくとも2026年11月21日までのプロモーション価格と注記されています。
| モデル | Input | Cached Input | Cache Write | Output |
|---|---|---|---|---|
| GPT-5.6 Sol | $4.00 | $0.40 | $5.00 | $20.00 |
| GPT-5.6 Terra | $2.00 | $0.20 | $2.50 | $12.00 |
| GPT-5.6 Luna | $0.20 | $0.02 | $0.25 | $1.20 |
2. KVキャッシュは何を省き、何を消費するのか
Transformerは入力をトークンごとに処理する際、各層のKeyとValueを次トークン用に保持します。これがKVキャッシュです。同一の先頭部分を持つ後続リクエストでは、その部分の再計算を避けられるため、長いシステム指示、固定のツール定義、共通知識を含む入力ほど効果が出ます。
ただし「キャッシュ」は無料の魔法ではありません。保持にはGPUメモリまたはそれに準じる資源が必要で、キャッシュの寿命、最小プレフィックス長、完全一致が求められる範囲、並列リクエストへの扱いはプロバイダーごとに異なります。可変の日時、ユーザーごとに順序が変わるツール定義、毎ターン全文を差し替える履歴は、ヒットを壊しやすい要因です。
- 不変のシステム指示・安全方針・ツール定義を先頭に固定する
- 顧客データ、検索結果、今回の指示など変動部分は後ろへ寄せる
- キャッシュの可否ではなく、実際の cached / uncached input token をログで分けて観測する
- キャッシュ共有の可否とデータ保持条件を、性能要件とは別にセキュリティ審査する
3. エージェントの実効コストは「ヒット率×反復回数」で決まる
実効入力単価は、通常入力比率を 1 − h、キャッシュヒット率を h、キャッシュ価格比を c と置けば、おおまかに P × ((1 − h) + c × h) と表せます。90%割引なら c = 0.1 です。しかしエージェントでは、この入力単価にターン数、各ターンで追加されるツール結果、出力、失敗した再試行が掛かります。
したがって、9割のキャッシュ割引を前提に予算を組むより、まずキャッシュ非ヒットでも成立する上限を設ける方が安全です。ターン上限、ツール出力の要約、重複検索の除去、失敗時の指数バックオフ、タスク単位のトークン予算を同時に導入します。割引は達成できたときの改善分として扱います。
4. 主要モデル定性比較:用途ポジショニング
以下の表は、公式料金を根拠に4モデルの用途ポジション・実効コスト傾向・レイテンシ特性を定性的にまとめたものです。MMLU等の精度指標の具体数値は公開状況が不均一なため記載せず、実測値は別記事で検証予定です(詳細は本記事末尾の予告を参照)。ZDRをはじめとするデータガバナンス要件の達成可否は、各プロバイダーの契約条件で個別に確認してください。
| モデル | 用途ポジション | 実効コスト傾向 | レイテンシ特性 | 留意点 |
|---|---|---|---|---|
| GPT-5.6 Sol | 最高品質・高難度推論 | 最高水準(Input $4.00/M) | 即時・低遅延優先 | 2026年11月21日までプロモーション価格 |
| GPT-5.6 Terra | 品質とコストのバランス | 中程度(Input $2.00/M) | 即時・Flex・Batch対応 | 幅広い用途の第一候補 |
| GPT-5.6 Luna | 大量処理・定型タスク | 最低水準(Input $0.20/M) | Batch/Flex向き・大量並列 | 出力品質の実測確認を推奨 |
| Claude Sonnet 5 | 高品質・長文コンテキスト | 中〜高(Anthropic公式参照) | 即時・Batches対応 | Prompt Cachingの条件はAnthropicで確認 |
5. Lunaの4つの運用区分:経路選択の整理
OpenAIが公式に提供する処理モードは、Standard(即時)・Flex・Batch APIの3つです。以下では、これに「リアルタイム/低遅延」用途の運用上の概念を加え、4区分として整理します。これらは運用上の呼称であり、OpenAIが公式に命名した専用エンドポイント製品名として断定するものではありません。
| 運用上の区分 | 処理モード(公式) | 想定ユースケース | 割引の有無 |
|---|---|---|---|
| リアルタイム/低遅延 | Standard(即時) | 顧客対応チャット、対話型エージェント | なし(通常料金) |
| 標準非同期 | Flex | キュー処理、スループット優先の分類・要約 | Standard比50%(公式確認済み) |
| 大量一括 | Batch API | 夜間バッチ、大量ラベル付け、評価セット | Standard比50%(公式確認済み) |
| オフピーク即時(運用上の仮定) | Standard(時間帯管理) | 低トラフィック時間帯のコスト最適化 | ※OpenAI公式のオフピーク割引は未確認。一般的な運用仮定として検討されうる概念 |
単純化した試算例として、GPT-5.6 SolのStandard・短文コンテキストで、100万トークンの固定プレフィックスを計4回送る場合を示します。すべて通常入力なら $4.00 × 4 = $16.00、初回をCache Write、後続3回をCached Inputとすると $5.00 + $0.40 × 3 = $6.20 です(61.25%減)。出力トークンと各リクエストの変動部分は含みません。
6. 業務タスク別推奨ルーティング設計
即時処理・キャッシュ前提の反復処理・遅延許容の一括処理を一つのエージェントに混在させると、最適でないモデル・経路で実行されるケースが生じます。以下のマトリクスは、代表的な業務タスクごとの優先候補を定性的に示したものです。モデルの品質・コスト・レイテンシの実測値は別途確認してください。
| 業務タスク例 | 優先候補 | 理由(定性) | 経路 |
|---|---|---|---|
| 顧客対応・リアルタイムチャット | Sol / Terra | 応答品質と低遅延が価値を直接決める | Standard(即時) |
| 文書分類・ラベル付け(大量) | Luna | 定型処理・遅延許容・コスト最優先 | Batch / Flex |
| 長文要約・翻訳 | Terra / Luna | 出力長に対してコストを抑えたい。品質要件による | Flex / Batch |
| 高難度の推論・法務・医療判断 | Sol | 品質最優先・件数が少なく単価が問題になりにくい | Standard(即時) |
| 夜間バッチ・評価セット生成 | Luna | 非同期で十分・最低実効コスト | Batch API(50%割引) |
| エージェント内の分類・振り分けステップ | Luna | 軽量処理・高頻度・コスト積み上がりを抑える | Flex / Batch |
こうした経路選択を各アプリケーションに散在させず、利用モデル、データ区分、予算、監査ログを一元化するゲートウェイ層で制御すると、価格改定・モデル更新時にも差し替えと検証を行いやすくなります。RiN Gatewayのような共通ゲートウェイを検討する場合も、最初に必要なのは特定ベンダーへの固定ではなく、実測可能なルーティング方針です。ZDR要件・データ境界・監査ログの一元管理という観点でも、ゲートウェイ層の整備はコスト最適化と同時に達成できます。
7. まとめ:Lunaの登場で設計の選択肢が広がった
GPT-5.6 Lunaは、Agenticワークロードにおける「安価な処理経路」の選択肢を現実的にしました。ただし、最安モデルを使えばよいという単純な話ではありません。ZDR前提の契約条件、実際のキャッシュヒット率、出力品質の実測、業務ごとの遅延許容度、そして複数プロバイダーを同じ計測単位で比較すること。これらを積み上げて初めて、LunaをいつSolやTerraの代わりに使えるかが見えてきます。即時処理・キャッシュ前提の反復処理・遅延許容の一括処理を分離し、価格改定に振り回されないマルチLLM推論の基盤を作ることが出発点です。
よくある質問
Cached Input 90%割引なら、入力コストは常に10分の1ですか?
いいえ。割引はキャッシュ条件を満たして再利用された入力部分に限られます。通常入力、出力、キャッシュ対象外の変動部分、再試行は別に発生します。請求・利用ログで cached input tokens を分けて確認し、非ヒット時でも予算内に収まる設計にしてください。
ZDR(Zero Data Retention)契約はどのプロバイダーでも利用できますか?
ZDR(Zero Data Retention)はプロバイダーがAPIリクエスト・レスポンスのログを保持しないことを指し、モデルの学習非利用とは別個の契約項目です。OpenAIとAnthropicは公式ドキュメントでZDR相当の条件(保持期間・ログ管理)を説明しています。Google(Vertex AI)のエンタープライズ契約でも保持期間の条項があります。Tencent TokenHub経由のDeepSeek V4-ProについてはZDR・データ保持・学習非利用のいずれも、TokenHub固有の契約を直接確認する必要があります。各社の最新の利用規約・DPAを、社内の情報セキュリティ審査と照合してください。
GPT-5.6 LunaはすべてのAgenticタスクでSolやTerraを置き換えられますか?
置き換えられないケースがあります。Lunaは大量処理・定型タスク・遅延許容用途で実効コストを抑える強みを持ちますが、高難度の推論・品質最優先の判断・リアルタイム対話では、SolやTerraの方が適している場合があります。まず同じ代表タスクで出力品質・ヒット率・実効コストを実測し、置き換え可否を判断することを推奨します。
KVキャッシュを効かせるために、全会話履歴を毎回送るべきですか?
必ずしもそうではありません。長い履歴は出力品質に必要な文脈を含む一方、メモリ、入力、ターン数を増やします。不変部分を固定し、古い履歴やツール出力は要約・削除し、必要資料だけを取得する設計が有効です。実測した品質、ヒット率、総トークンで判断します。
参照した一次情報
OpenAI
- OpenAI API Documentation, “Pricing.”(GPT-5.6 Sol / Terra / Luna、Standard / Batch / Flex料金) https://developers.openai.com/api/docs/pricing
- OpenAI, “Advancing the price-performance frontier with GPT-5.6,” July 30, 2026. https://openai.com/index/advancing-the-price-performance-frontier-with-gpt-5-6/
- OpenAI API Documentation, “Batch API.” https://developers.openai.com/api/docs/guides/batch
- OpenAI API Documentation, “Flex processing.” https://developers.openai.com/api/docs/guides/flex-processing
arXiv
- arXiv, “arXiv:2601.06007.”(本文では内容を要約して参照) https://arxiv.org/abs/2601.06007
Anthropic
- Anthropic Documentation, “Prompt caching.” https://platform.claude.com/docs/en/build-with-claude/prompt-caching
- Anthropic Documentation, “Message Batches.” https://platform.claude.com/docs/en/build-with-claude/batch-processing
Google Cloud
- Google Cloud Documentation, “Context caching overview.” https://docs.cloud.google.com/gemini-enterprise-agent-platform/models/context-cache/context-cache-overview
- Google Cloud Documentation, “Batch inference.” https://docs.cloud.google.com/gemini-enterprise-agent-platform/reference/models/batch-prediction-api
記事情報
| 執筆 | 久坂 祐介(株式会社Metelix 代表取締役CEO / CAIO) |
|---|---|
| 技術監修 | 株式会社Metelix エンジニアリングチーム |
| 公開日 | |
| 最終更新日 | |
| 分類 | 技術解説・インフラ試算 |
| 利害関係 | 本記事は、AIゲートウェイ製品であるRiN Gatewayを提供する株式会社Metelixが執筆しています。本文の各社資料は、それぞれの組織が公開した一次情報を参照しています。 |
| 評価時点 | 2026年8月25日。料金、対応モデル、キャッシュ・Flex・Batchの適用条件は変更される場合があります。購入・実装時は各社の最新の公式文書および契約条件をご確認ください。 |
関連記事
- 2026.08.17|解説DeepSeek最大1,100%値上げの真相:エージェント時代における「KVキャッシュ頼み」の終焉と現場の生存戦略
- 2026.08.03|解説MCP最大の改訂は「認可」だった:社内SaaSをすべてRAGに入れてはいけない理由
- 2026.09.10|解説AIネイティブ経営論 第1回:「AIを使う」から「仕事を任せる」へ
改訂履歴
| 初版公開 | |
| タイトル変更・Luna章追加・ZDR前提明記・5モデル定性比較表・Lunaの4区分整理・業務別ルーティング設計・近日公開予告を追加 | |
| 本文の表現推敲・構成の平易化 |